Prompt Caching là gì? Cách dùng cache trong Claude API giảm tới 90% chi phí
Prompt caching giúp giảm tới 90% chi phí gọi Claude API cho phần nội dung lặp lại. Tìm hiểu cơ chế cache write, cache read và cách triển khai đúng.
Bởi Danh Võ — 11 Tháng 11, 2026 trong Hướng dẫn AI
Prompt caching là cơ chế giúp bạn gọi AI nhiều lần với cùng một đoạn nội dung dài (system prompt, tài liệu đính kèm, few-shot example) mà không phải trả tiền xử lý lại từ đầu mỗi lần. Với Claude API, phần nội dung được cache chỉ tính giá bằng 10% so với input bình thường ở những lần gọi sau — tức tiết kiệm tới 90% cho đúng phần đó. Nếu bạn đang xây chatbot, trợ lý đọc tài liệu hay AI agent gọi API liên tục, đây là thứ đầu tiên nên bật trước khi nghĩ đến việc đổi sang model rẻ hơn.
Prompt caching là gì?
Mỗi lần gọi API, AI phải “đọc” toàn bộ prompt đầu vào trước khi sinh câu trả lời — kể cả khi 90% nội dung đó giống y lần gọi trước (ví dụ system prompt dài 5.000 từ, hướng dẫn nghiệp vụ, hoặc toàn bộ nội dung một file PDF bạn đính kèm để hỏi nhiều câu). Prompt caching cho phép lưu lại trạng thái đã xử lý của phần nội dung lặp lại đó, để lần gọi sau AI không cần xử lý lại, chỉ cần “đọc từ cache”.
Về bản chất, đây không phải tính năng làm AI “nhớ” qua các cuộc hội thoại khác nhau — nó chỉ tối ưu chi phí và tốc độ cho những lần gọi API có phần đầu prompt giống nhau. Khái niệm này liên quan chặt tới context window — cửa sổ ngữ cảnh mà model xử lý trong một lần gọi, vì cache càng dài thì tiềm năng tiết kiệm càng lớn.
Cơ chế hoạt động: Cache Write và Cache Read
Prompt caching trong Claude API hoạt động qua 2 bước, đánh dấu bằng một “breakpoint” trong prompt:
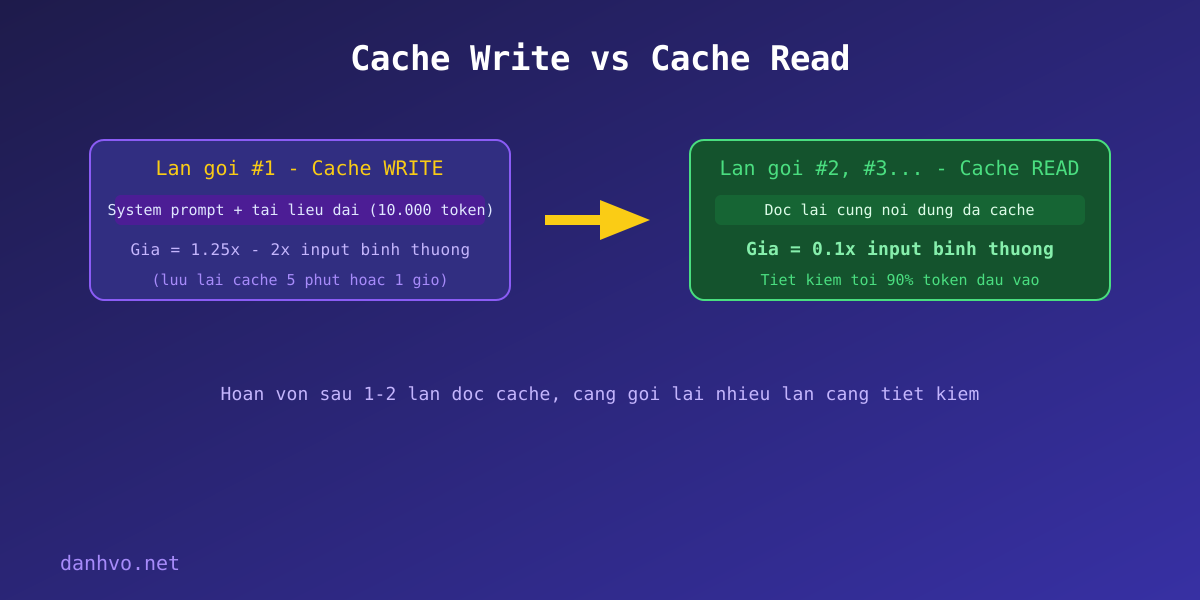
- Cache write (lần gọi đầu tiên): AI xử lý và lưu lại phần nội dung được đánh dấu cache. Chi phí cho phần này cao hơn input bình thường — gấp 1,25 lần nếu cache giữ 5 phút, gấp 2 lần nếu giữ 1 giờ.
- Cache read (các lần gọi sau, trong thời gian cache còn hiệu lực): AI đọc lại phần đã cache mà không cần xử lý lại. Chi phí chỉ còn 0,1 lần (10%) so với giá input gốc.
Nói cách khác: lần đầu bạn trả thêm một chút để “ghi cache”, nhưng từ lần đọc thứ 1-2 trở đi là hoàn vốn, và mọi lần gọi tiếp theo gần như miễn phí cho phần nội dung đó. Các hệ số này được Anthropic công bố chính thức trong bài giới thiệu prompt caching và cập nhật liên tục trên trang pricing của Claude API, nên trước khi tính toán chi phí cho sản phẩm thật, bạn nên đối chiếu lại số mới nhất ở đó.
Tiết kiệm được bao nhiêu tiền? Ví dụ cụ thể
Giả sử bạn xây chatbot hỏi đáp dựa trên một bộ tài liệu nội bộ dài 20.000 token, và có 100 người dùng hỏi trong ngày (mỗi câu hỏi là một lần gọi API riêng, dùng chung tài liệu này).
| Cách gọi | Token phải tính phí cho phần tài liệu | Hệ số giá |
|---|---|---|
| Không dùng cache (100 lần gọi) | 20.000 × 100 = 2.000.000 token | 1x mỗi lần |
| Dùng cache: lần 1 (ghi cache) | 20.000 token | 1,25x – 2x |
| Dùng cache: 99 lần sau (đọc cache) | 20.000 × 99 = 1.980.000 token | 0,1x mỗi lần |
Không cache, bạn trả phí như gọi 2 triệu token input. Có cache, chi phí tương đương chỉ còn khoảng 10-12% của con số đó — vì 99/100 lần gọi chỉ tính 10% giá. Tài liệu càng dài, số lần gọi lại càng nhiều, mức tiết kiệm càng rõ.
Cách bật prompt caching trong Claude API
Bạn không cần hạ tầng riêng để cache — chỉ cần đánh dấu điểm cache (cache breakpoint) ngay trong request gửi lên API, bằng tham số cache_control đặt ở cuối block nội dung muốn cache. Vài lưu ý khi triển khai:
- Đặt breakpoint ngay sau phần nội dung ổn định, lặp lại — ví dụ system prompt, tài liệu tham khảo, danh sách tool — và để phần câu hỏi của người dùng (luôn thay đổi) nằm sau breakpoint, ngoài vùng cache.
- Cache có thời gian sống (TTL) — 5 phút hoặc 1 giờ tùy lựa chọn. Nếu không có lần gọi nào trong khoảng đó, cache hết hạn và lần gọi tiếp theo lại tính giá ghi cache (write) từ đầu.
- Nội dung cache phải giống chính xác từng token ở các lần gọi để được tính là cache hit — chỉ cần đổi một ký tự trong phần đã cache là mất cache.
- Theo dõi số liệu
cache_creation_input_tokensvàcache_read_input_tokenstrả về trong response để biết cache có đang hoạt động đúng không.
Khi nào nên dùng cache
Hiệu quả rõ nhất khi: system prompt hoặc tài liệu đính kèm dài (vài nghìn token trở lên), và bạn gọi lại nhiều lần trong thời gian ngắn — chatbot hỏi đáp tài liệu, AI agent lặp lại nhiều bước với cùng bộ hướng dẫn, ứng dụng có nhiều người dùng cùng tra cứu một nguồn dữ liệu.
Khi nào không cần
Với các prompt ngắn, dùng một lần duy nhất, hoặc nội dung thay đổi liên tục ở ngay phần đầu — cache không giúp được gì, thậm chí tốn thêm vì phải trả phí ghi cache mà không có lần đọc lại.
Các model Claude nào hỗ trợ cache tốt nhất?
Toàn bộ dòng Claude hiện tại đều hỗ trợ prompt caching với hệ số 0,1x cho cache read. Một số model mới còn tối ưu sâu hơn cho tác vụ dùng nhiều cache: Claude Fable 5.1 và Claude Haiku 5.5 đều được Anthropic công bố giảm thêm chi phí cache so với thế hệ trước, phù hợp cho ứng dụng gọi API khối lượng lớn. Nếu chưa rõ nên chọn model nào cho công việc của mình, có thể xem thêm bài Claude 5.5: Nên chọn Opus, Sonnet hay Haiku.
Các AI khác có cơ chế tương tự không?
Có. OpenAI và Google Gemini đều cung cấp cơ chế cache riêng cho phần prompt lặp lại, với mục tiêu tương tự: giảm chi phí và tăng tốc độ phản hồi cho các lần gọi dùng lại cùng nội dung. Cách tính phí và thời gian lưu cache của mỗi hãng khác nhau và có thể thay đổi theo thời gian, nên nếu đang dùng OpenAI hoặc Gemini, bạn nên kiểm tra trực tiếp trang pricing chính thức của hãng đó trước khi áp dụng vào sản phẩm thật, tránh tính sai chi phí.
Câu hỏi thường gặp
Prompt caching có làm giảm chất lượng câu trả lời không?
Không. Cache chỉ là tối ưu cách xử lý phần input lặp lại, không thay đổi cách model suy luận hay sinh câu trả lời.
Cache có tự động bật không hay phải code riêng?
Với Claude API, bạn cần chủ động đánh dấu breakpoint bằng cache_control trong request — không tự động bật nếu không khai báo.
Dùng cache có rủi ro gì không?
Rủi ro chính là tính sai: nếu nội dung cache thay đổi liên tục hoặc số lần đọc lại quá ít, phần phí ghi cache (1,25x-2x) có thể khiến tổng chi phí cao hơn không dùng cache. Nên đo thử trên traffic thật trước khi áp dụng toàn bộ.
Kết luận
Prompt caching là cách tối ưu chi phí gọi AI dễ triển khai nhất mà nhiều người bỏ qua vì tưởng phải đổi hạ tầng. Chỉ cần tách đúng phần nội dung lặp lại ra khỏi phần thay đổi và đánh dấu cache, bạn có thể giảm tới 90% chi phí cho những ứng dụng gọi API liên tục với cùng system prompt hoặc tài liệu. Trước khi tìm model rẻ hơn, hãy kiểm tra xem ứng dụng của bạn đã dùng cache đúng cách chưa.