Google, OpenAI, Anthropic thống nhất chuẩn robots.txt mới chặn AI huấn luyện
Google, OpenAI, Microsoft và Anthropic vừa công bố cùng tôn trọng một chuẩn robots.txt chung để chặn AI huấn luyện. Token __usage_ai-training hoạt động ra sao, áp dụng khi nào, và bạn cần làm gì ngay.
Bởi Danh Võ — 4 Tháng 11, 2026 trong AI
Suốt hai năm qua, mỗi hãng AI có một con bot riêng để thu thập dữ liệu huấn luyện — GPTBot của OpenAI, Google-Extended của Google, ClaudeBot của Anthropic — và chủ website muốn chặn AI huấn luyện phải tự tay khai báo từng dòng cho từng bot trong robots.txt. Ngày 30/10/2026, Google, OpenAI, Microsoft và Anthropic cùng công bố sẽ tôn trọng một chuẩn robots.txt chung duy nhất để opt-out khỏi việc huấn luyện AI, thay vì bắt webmaster phải nhớ hết tên từng bot. Bài này giải thích tín hiệu mới hoạt động ra sao, ai đã áp dụng, và bạn nên làm gì với website của mình ngay lúc này.
Chuyện gì vừa xảy ra ngày 30/10/2026?
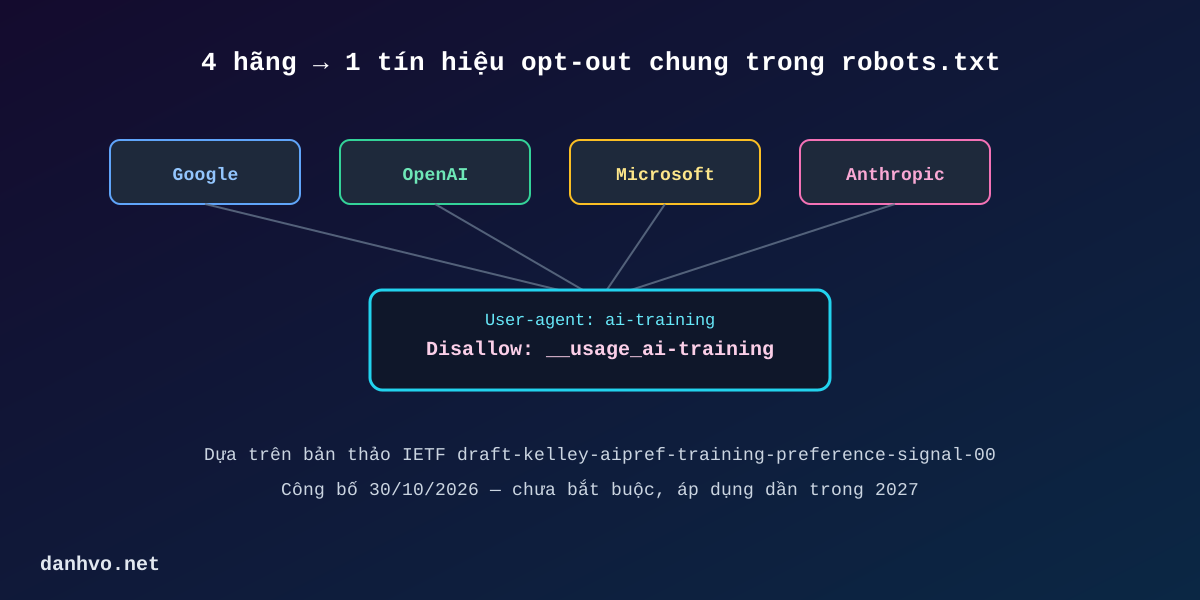
Bốn công ty AI lớn nhất hiện nay xác nhận sẽ cùng tôn trọng một tín hiệu opt-out AI huấn luyện duy nhất, đặt trong file robots.txt mà hầu hết website đã có sẵn. Thay vì phải liệt kê riêng GPTBot, Google-Extended, ClaudeBot, Bingbot… webmaster chỉ cần khai báo một nhóm user-agent mới mang tên tín hiệu chung, và cả bốn hãng sẽ đọc hiểu cùng một cách.
Đề xuất kỹ thuật đứng sau chuẩn này là một bản thảo cá nhân (individual draft) gửi lên IETF, do Kevin Kelley của Anthropic soạn, mang tên draft-kelley-aipref-training-preference-signal-00. Bản thảo này còn phải qua nhóm làm việc AI Preferences (AIPREF) của IETF trước khi trở thành chuẩn chính thức — nghĩa là mọi thứ vẫn đang ở giai đoạn tự nguyện, chưa có ràng buộc pháp lý nào bắt các bot khác phải tuân theo. Thông tin về việc bốn hãng cùng cam kết tôn trọng tín hiệu này được TNW tổng hợp chi tiết ngay sau khi công bố.
Token __usage_ai-training hoạt động thế nào?
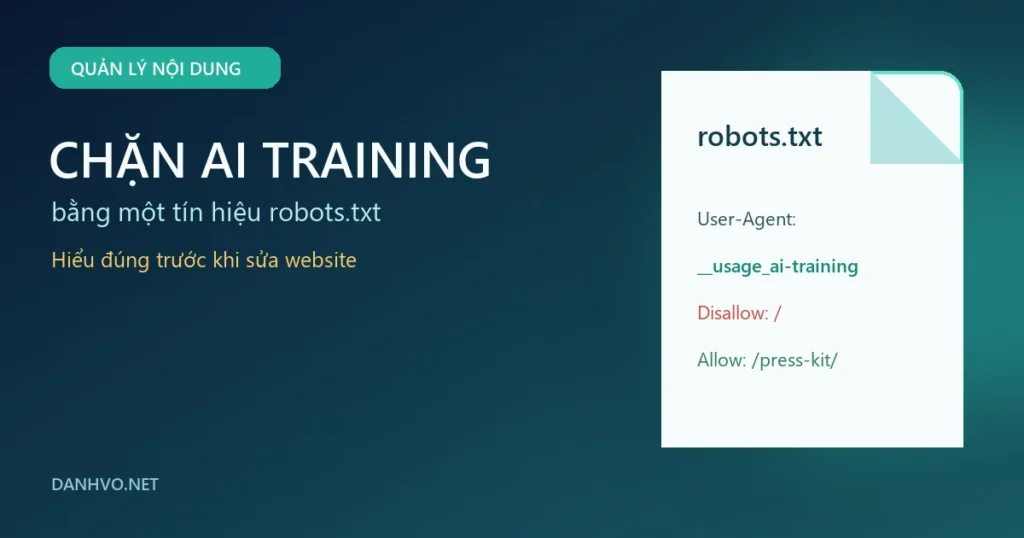
Thay vì sinh thêm một bot ảo, chuẩn mới thêm một token chính sách gọi là __usage_ai-training vào khuôn khổ robots.txt đang có. Token này có thể áp cho toàn site hoặc chỉ một số đường dẫn cụ thể, dùng cú pháp quen thuộc:
User-agent: ai-training
Disallow: /

User-agent: ai-training
Disallow: /tai-lieu-noi-bo/
Có một điểm dễ gây nhầm: nhóm User-agent: * (áp cho mọi bot) không tự động mang theo tín hiệu này. Bản thảo của Kelley thiết kế có chủ đích để dòng wildcard quen thuộc “mù” với token mới, buộc webmaster phải khai báo riêng một nhóm mang đúng tên tín hiệu. Nếu chỉ sửa dòng User-agent: * như trước đây, bạn vẫn chưa opt-out được theo chuẩn mới.
Từng hãng áp dụng ra sao?
Dù cùng cam kết tôn trọng một tín hiệu, cách triển khai thực tế của bốn hãng lại chưa hoàn toàn giống nhau:
| Hãng | Tình trạng áp dụng | Ghi chú |
|---|---|---|
| Cam kết hỗ trợ, mốc thời gian đầu năm 2027 | Nếu site dùng token mới mà không khai riêng Google-Extended, Google sẽ coi đó là chặn luôn Google-Extended | |
| OpenAI | Sẽ tôn trọng tín hiệu “trong vài tháng tới” | GPTBot và các quy tắc robots.txt hiện có của OpenAI vẫn áp dụng song song, không bị thay thế |
| Microsoft | Có cơ chế riêng, tách bạch hai việc | Phân biệt rõ “opt-out huấn luyện” và việc trả lời có trích dẫn/liên kết nguồn (grounded answers) của Copilot |
| Anthropic | Đơn vị đề xuất chuẩn, đang triển khai sớm nhất | Vẫn giữ cơ chế chặn ClaudeBot riêng qua robots.txt như trước, token mới là lớp bổ sung |
Nói cách khác, chuẩn robots.txt mới không xóa bỏ các dòng chặn bot cũ như GPTBot hay Google-Extended — nó là một lớp tín hiệu chung nằm bên trên, giúp bạn không phải cập nhật thủ công mỗi khi có một AI crawler mới xuất hiện. Nếu muốn hiểu cách khai báo từng bot theo kiểu cũ, bạn có thể xem lại cách chặn AI dùng nội dung website để huấn luyện bằng robots.txt mà mình đã viết trước đó.
Vì sao chưa nên chủ quan hoàn toàn?
- Chưa bắt buộc: Đây là tín hiệu tự nguyện, không phải luật. Một bot tuân thủ tốt vẫn có thể bỏ qua nếu công ty đứng sau không tham gia cam kết.
- Chỉ có hiệu lực từ lúc khai báo về sau: Token chỉ ảnh hưởng tới dữ liệu thu thập sau khi bạn thêm vào robots.txt, không “xóa” dữ liệu đã bị dùng để huấn luyện từ trước.
- Thời điểm áp dụng lệch nhau: Google nói đầu 2027, OpenAI nói “vài tháng tới” — tức là ngay lúc bạn thêm token, không phải cả bốn hãng sẽ tôn trọng nó cùng lúc.
- Vẫn còn hàng chục AI crawler khác (Perplexity, các startup nhỏ, công cụ nội bộ của doanh nghiệp…) chưa cam kết theo chuẩn này, nên các dòng chặn bot riêng lẻ trong robots.txt vẫn cần giữ lại.
Bạn nên làm gì với website của mình ngay bây giờ?
- Mở file
robots.txtở thư mục gốc website, kiểm tra các nhómUser-agentđang có. - Thêm nhóm mới dùng token
ai-trainingnếu muốn opt-out khỏi việc huấn luyện AI trên toàn site hoặc theo đường dẫn cụ thể. - Giữ nguyên các dòng chặn GPTBot, Google-Extended, ClaudeBot… hiện có — chuẩn mới chỉ bổ sung, không thay thế.
- Nếu bạn vẫn muốn nội dung được AI dùng để trả lời có trích dẫn (ví dụ Copilot, Perplexity dẫn link về site), đừng nhầm “chặn huấn luyện” với “chặn hiển thị/trích dẫn” — đây là hai cơ chế khác nhau, đặc biệt với Microsoft.
- Theo dõi lại sau vài tháng, vì mốc thời gian từng hãng công bố (2027 với Google, “vài tháng tới” với OpenAI) có thể thay đổi khi bản thảo IETF được chỉnh sửa.
Nếu bạn còn lo về việc dữ liệu cá nhân hay nội dung có bản quyền bị AI “ăn” vào mô hình dù đã chặn, phần rủi ro này mình đã phân tích kỹ hơn trong bài dữ liệu riêng tư, bản quyền và thiên lệch khi dùng AI. Ngoài ra, nếu bạn muốn biết thêm vì sao các hãng AI ngày càng cẩn trọng với nguồn dữ liệu huấn luyện, bài OpenAI ngừng huấn luyện AI trên internet “sống” cũng là một góc nhìn liên quan.
Câu hỏi thường gặp
Token ai-training có thay thế được GPTBot, Google-Extended không?
Không. Đây là lớp tín hiệu bổ sung. Các dòng khai báo chặn GPTBot, Google-Extended, ClaudeBot riêng lẻ vẫn cần giữ lại trong robots.txt vì chuẩn mới chưa được mọi AI crawler trên thị trường tôn trọng.
Thêm token này vào robots.txt có ảnh hưởng đến SEO trên Google Search không?
Không. Tín hiệu opt-out AI huấn luyện là cơ chế riêng, tách biệt với việc Googlebot thu thập dữ liệu để xếp hạng tìm kiếm. Bạn vẫn cần giữ nguyên quyền truy cập cho Googlebot thông thường nếu muốn trang được index.
Website nhỏ, ít người biết đến thì có cần quan tâm chuẩn này không?
Nếu bạn lo nội dung bị dùng huấn luyện AI mà không được phép, nên thêm ngay vì chi phí chỉ là vài dòng text trong robots.txt. Nhưng đừng kỳ vọng nó chặn được 100% — vẫn cần kết hợp theo dõi log server để phát hiện bot lạ.
Chuẩn robots.txt mới cho chặn AI huấn luyện là bước đi đúng hướng để giảm việc mỗi hãng tự đặt ra một con bot, một luật riêng. Nhưng vì vẫn là tín hiệu tự nguyện, chưa có ràng buộc pháp lý, và mốc thời gian áp dụng giữa các hãng không đồng nhất, cách an toàn nhất hiện tại là dùng nó như một lớp bổ sung — chứ không xóa bỏ các dòng chặn bot cũ mà bạn đã có.