Cách chặn AI dùng nội dung website để huấn luyện bằng robots.txt
Cách dùng tín hiệu robots.txt chung để từ chối AI training, giữ SEO và tránh nhầm với GPTBot, Google-Extended hay Content-Signal.
Bởi Võ Danh — 1 Tháng 11, 2026 trong AI
Chặn AI training bằng robots.txt lâu nay khá lắt nhắt. Chủ website phải biết GPTBot là của OpenAI, Google-Extended liên quan đến Google, rồi tiếp tục cập nhật danh sách khi một hãng đổi tên bot hoặc có thêm crawler mới. Ngày 30/10/2026, OpenAI, Google và Microsoft cùng công bố kế hoạch hỗ trợ một tín hiệu chung. Thay vì viết luật riêng cho từng nhà, website có thể nói “không dùng nội dung này để huấn luyện AI tạo sinh” bằng một nhóm quy tắc duy nhất.
Ý tưởng nghe gọn, và đúng là gọn thật. Nhưng đừng vội xóa các quy tắc đang chạy. Tín hiệu mới hiện nằm trong một Internet-Draft, tức bản dự thảo kỹ thuật đang được thảo luận, chưa phải tiêu chuẩn IETF đã hoàn tất. OpenAI nói sẽ triển khai trong những tháng tới; Google đặt mục tiêu hỗ trợ trong năm 2027. Trong thời gian chuyển tiếp, cách an toàn là thêm tín hiệu chung nhưng vẫn giữ điều khiển riêng của từng hãng.
Bài này giải thích cú pháp, giới hạn và cách triển khai thực tế trên WordPress hoặc website tự quản. Phần dễ nhầm nhất cũng được tách riêng: tín hiệu mới không giống hoàn toàn dòng Content-Signal của Cloudflare, và robots.txt không phải ổ khóa chống sao chép.
Tín hiệu chung để chặn AI training bằng robots.txt là gì?
Dự thảo Machine-Readable Training Preference Signal do Kevin Kelley của Anthropic viết. Nó dùng cấu trúc quen thuộc của robots.txt, không thêm tên chỉ thị mới. Điểm mới nằm ở một policy token, hiểu đơn giản là tên đại diện cho mục đích sử dụng nội dung:
User-Agent: __usage_ai-training
Disallow: /
Trong nhóm này, __usage_ai-training không phải tên của một con bot cụ thể. Nó đại diện cho mục đích “AI training”. Theo dự thảo, AI training là việc dùng nội dung để thay đổi các tham số đã học của mô hình AI tạo sinh. Các mô hình chỉ làm phân loại, xếp hạng hoặc chấm điểm không nằm trong định nghĩa đó, dù chúng có thể tạo phần giải thích đi kèm.
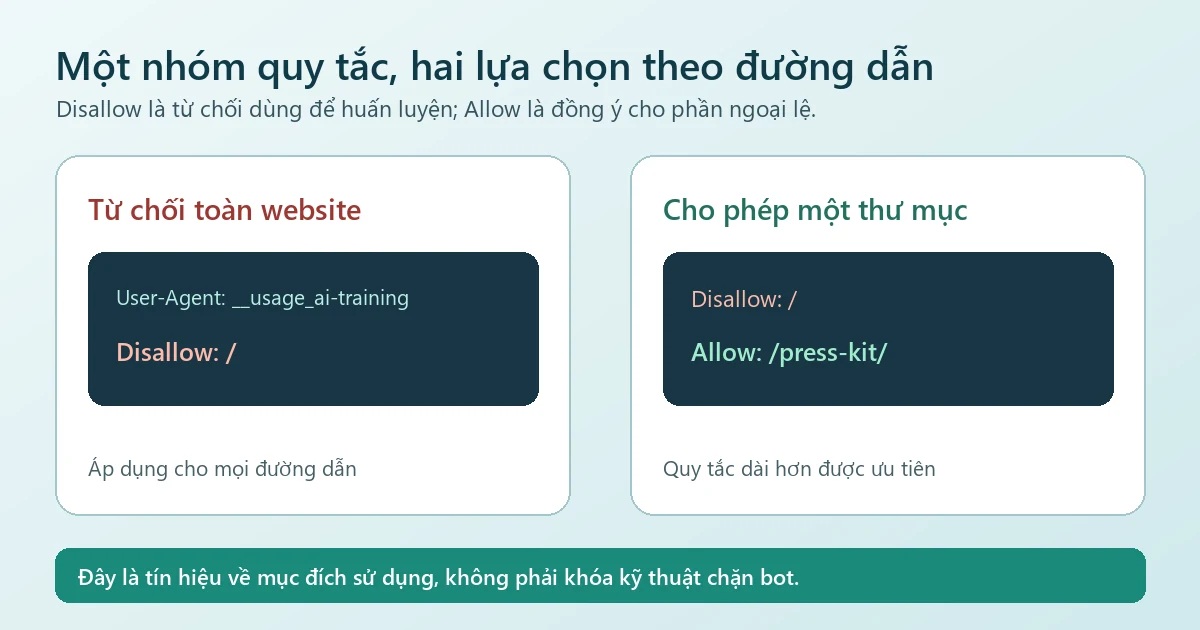
Disallow: / thể hiện lựa chọn phản đối dùng toàn bộ nội dung website cho mục đích huấn luyện nói trên. Nếu muốn đồng ý, website dùng Allow. Nếu không có nhóm mang policy token này, dự thảo coi như website chưa bày tỏ lựa chọn qua cơ chế chung, chứ không tự suy ra là đồng ý hay từ chối.
Cú pháp đúng và cách tạo ngoại lệ theo thư mục
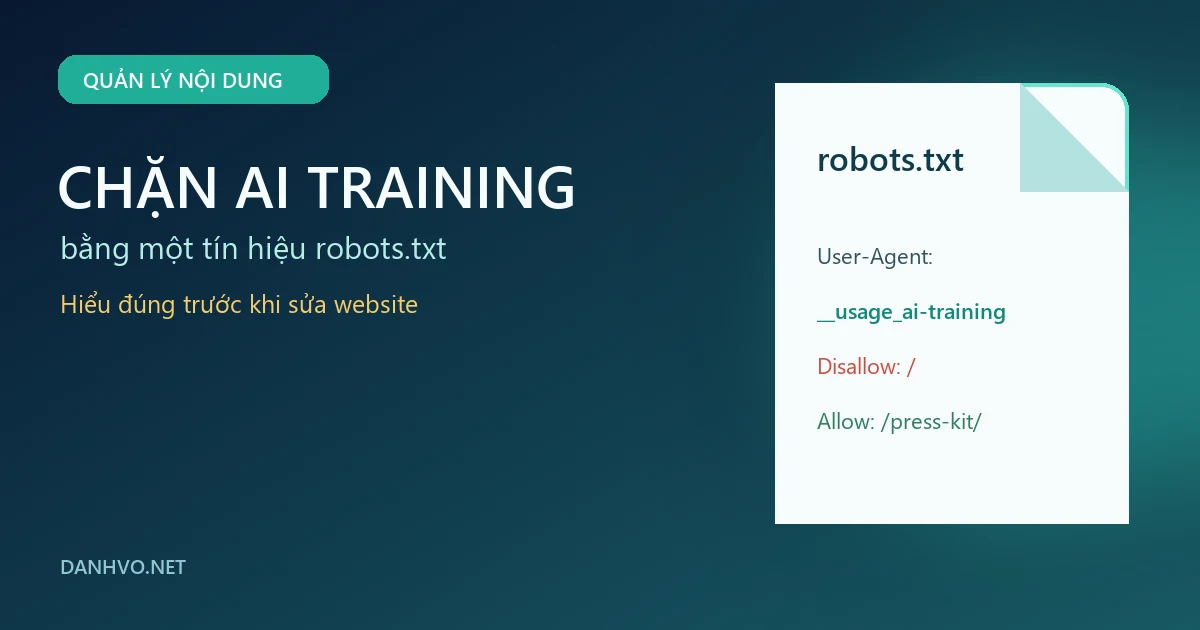
Ví dụ trong dự thảo từ chối huấn luyện trên toàn website nhưng cho phép dùng nội dung trong thư mục /press-kit/:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Cách so khớp đường dẫn vẫn theo quy tắc của robots.txt trong RFC 9309. Quy tắc cụ thể hơn, thường là đường dẫn dài hơn, được ưu tiên. Vì vậy /press-kit/ là ngoại lệ được phép, còn các đường dẫn khác vẫn bị từ chối cho AI training.
Một chi tiết rất dễ gõ sai: phải dùng đúng User-Agent: __usage_ai-training. Dự thảo yêu cầu nhóm wildcard User-Agent: * không được hiểu là khớp với policy token này. Nói cách khác, đoạn dưới đây chỉ quản lý truy cập của crawler nói chung; nó không thay cho tín hiệu mục đích huấn luyện:
User-Agent: *
Disallow: /
Cũng không nên tự đổi dấu gạch dưới, rút gọn tên hay sửa thành một câu nghe thuận mắt hơn. Máy không đoán ý tốt bụng như người. Token được so khớp chính xác, không phân biệt chữ hoa chữ thường.
Tín hiệu này có chặn bot truy cập website không?
Không. Dự thảo phân biệt hai việc: crawler có được truy cập một đường dẫn hay không, và nội dung lấy về được dùng vào mục đích gì. Nhóm __usage_ai-training nói về mục đích sử dụng. Nó không phải lệnh bắt máy chủ từ chối kết nối, cũng không tự tạo luật tường lửa.
Một nhà cung cấp có thể dựa vào lựa chọn đó để không thu thập nội dung nếu họ chỉ crawl cho việc huấn luyện. Tuy nhiên, website vẫn cần nhóm riêng theo tên bot khi muốn quản lý lưu lượng. Tài liệu crawler của OpenAI hiện tách OAI-SearchBot cho tìm kiếm khỏi GPTBot dùng để thu thập nội dung có thể phục vụ huấn luyện. Chặn GPTBot không đồng nghĩa phải biến website thành đảo hoang trong kết quả ChatGPT Search.
robots.txt cũng không phải cơ chế xác thực. Chính RFC 9309 nói các quy tắc này không phải một hình thức cấp quyền truy cập. Bot tuân thủ sẽ đọc và làm theo; bot cố tình bỏ qua vẫn có thể gửi yêu cầu như bình thường. Nếu nội dung thật sự nhạy cảm, hãy đặt sau đăng nhập, kiểm tra quyền ở máy chủ và dùng biện pháp chặn kỹ thuật. Đưa bí mật lên trang công khai rồi trông cậy robots.txt giống như dán tờ “xin đừng mở” lên ngăn kéo. Người lịch sự sẽ nghe, kẻ xấu thì chưa chắc.
Các quy tắc GPTBot và Google-Extended có còn cần không?
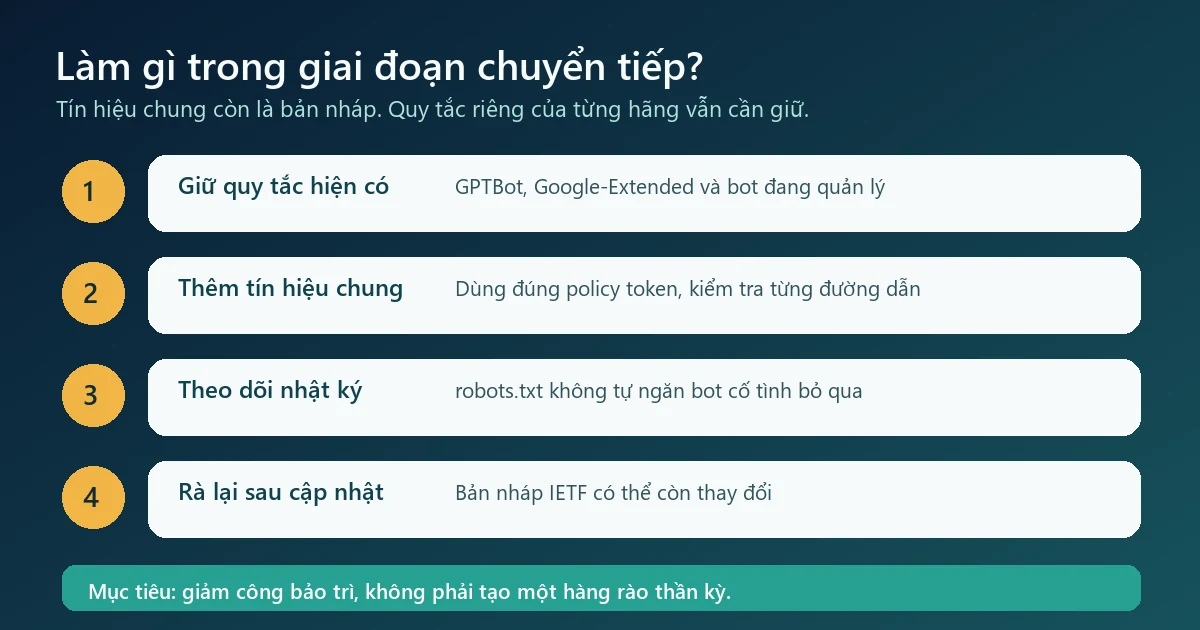
Có, ít nhất trong giai đoạn hiện tại. OpenAI xác nhận các điều khiển crawler sẵn có sẽ tiếp tục hoạt động. Google cũng nói quy tắc riêng cho Google-Extended sẽ chạy song song với tín hiệu chung. Nếu website từ chối qua policy token mới nhưng không ghi riêng Google-Extended, Google dự kiến hiểu đó như một lựa chọn từ chối Google-Extended. Website vẫn có thể đặt luật riêng cho Google khi cần.
Điều này cho phép một cấu hình khá thực tế: dùng tín hiệu chung làm lựa chọn mặc định cho các nhà cung cấp tham gia, sau đó ghi ngoại lệ theo từng hãng. Dự thảo còn nêu rằng biểu đạt cụ thể có thể được ưu tiên hơn biểu đạt chung. Dù vậy, cách mỗi công ty xử lý xung đột cần đọc trong tài liệu của chính họ khi tính năng được triển khai hoàn chỉnh.
Microsoft đi xa hơn với lựa chọn riêng cho grounding, tức dùng nội dung web làm nguồn để tạo câu trả lời tại thời điểm người dùng hỏi. Công ty nói lựa chọn về huấn luyện và grounding sẽ độc lập, đồng thời không làm thay đổi khả năng xuất hiện trong kết quả tìm kiếm Bing thông thường. Đây là lời nhắc quan trọng: “dùng để train”, “dùng làm nguồn trả lời” và “lập chỉ mục tìm kiếm” là ba mục đích khác nhau. Gộp cả ba vào một nút bật tắt sẽ tiện, nhưng hơi giống cầu dao tổng: tắt xong mới nhớ tủ lạnh cũng mất điện.
Đừng nhầm với Content-Signal của Cloudflare
Cloudflare đã có cơ chế Content-Signal trong robots.txt với các lựa chọn như search, ai-input và ai-train. Một cấu hình mẫu có thể trông như sau:
User-Agent: *
Content-Signal: ai-train=no, search=yes, ai-input=no
Allow: /
Cơ chế đó và dự thảo mới cùng giải quyết bài toán bày tỏ cách dùng nội dung, nhưng cú pháp không giống nhau. Dự thảo ngày 30/10/2026 dùng policy token __usage_ai-training cùng các dòng Allow/Disallow chuẩn. Nó cố ý không thêm chỉ thị mới để các bộ phân tích robots.txt cũ vẫn xử lý như trước và bỏ qua nhóm user-agent mà chúng không nhận biết.
Nếu đang dùng Bot Preference Sync của Cloudflare, đừng tự động thay cấu hình chỉ vì thấy một bài hướng dẫn mới. Hãy kiểm tra tài liệu Cloudflare và đầu ra thực tế tại https://tenmiencuaban/robots.txt. Cloudflare có thể ghép phần do họ quản lý vào robots.txt gốc. Sửa ở WordPress nhưng CDN tiếp tục chèn luật khác phía trước là chuyện hoàn toàn có thể xảy ra.
Cách triển khai trên WordPress mà không tự làm khó SEO
1. Ghi lại mục tiêu trước khi sửa
Hãy trả lời riêng ba câu: có cho công cụ tìm kiếm lập chỉ mục không, có cho hệ thống AI dùng nội dung để tạo câu trả lời kèm nguồn không, và có cho phép huấn luyện mô hình không. Nhiều website muốn câu trả lời là “có, có, không”. Nếu chỉ viết Disallow: / cho mọi bot, bạn có thể chặn luôn crawler tìm kiếm và tự cắt nguồn truy cập của mình.
2. Xác định nơi đang tạo robots.txt
WordPress có thể tạo robots.txt ảo. Plugin SEO, plugin bảo mật, máy chủ web hoặc CDN cũng có thể sửa nội dung trả về. Mở trực tiếp địa chỉ /robots.txt, rồi kiểm tra cấu hình ở lớp đang thật sự kiểm soát nó. Không nên tạo một file vật lý nếu hosting hoặc plugin đã có cơ chế quản lý khác mà chưa hiểu thứ tự ưu tiên.
3. Thêm tín hiệu chung nhưng giữ luật riêng
Một cấu hình chuyển tiếp có thể giữ nhóm GPTBot và Google-Extended hiện có, sau đó thêm nhóm policy token. Ví dụ dưới đây thể hiện lựa chọn từ chối huấn luyện; nó chỉ là mẫu, cần đối chiếu với mục tiêu của từng website:
User-Agent: GPTBot
Disallow: /

User-Agent: Google-Extended
Disallow: /

User-Agent: __usage_ai-training
Disallow: /

User-Agent: *
Allow: /

Sitemap: https://example.com/sitemap_index.xml
Đừng sao chép nguyên tên miền ví dụ. Cũng đừng xóa các luật kỹ thuật đang bảo vệ trang quản trị, kết quả tìm kiếm nội bộ hoặc khu vực tạo tải nặng. Tín hiệu AI training bổ sung một mục đích mới; nó không thay toàn bộ công việc quản lý bot.
4. Kiểm tra phản hồi và nhật ký
Sau khi lưu, mở robots.txt ở cửa sổ riêng, kiểm tra mã HTTP 200 và nội dung không bị cache bản cũ. Theo dõi access log để biết các user-agent vẫn truy cập những đường dẫn nào. Tên user-agent có thể bị giả mạo, vì vậy log là dữ liệu quan sát chứ không phải giấy chứng minh nhân dân của bot.
Có nên thêm tín hiệu mới ngay bây giờ?
Nếu website có chính sách rõ ràng về việc không cho dùng nội dung để huấn luyện AI tạo sinh, thêm tín hiệu chung là hợp lý. Nó ghi lựa chọn theo một cú pháp đã nhận được cam kết hỗ trợ từ nhiều nhà cung cấp lớn. Việc này cũng giảm công bảo trì về lâu dài nếu nhiều công ty cùng triển khai.
Nhưng cần ghi đúng trạng thái: đây là Internet-Draft cá nhân, chưa được IETF phê duyệt thành RFC. Bản dự thảo có thể được sửa, thay thế hoặc hết hạn. Việc OpenAI, Google và Microsoft công bố kế hoạch hỗ trợ là tín hiệu triển khai đáng chú ý, không biến tài liệu thành tiêu chuẩn hoàn chỉnh chỉ sau một đêm.
Website đang dùng quy tắc riêng không cần chạy đua xóa chúng. Cách ít rủi ro nhất là triển khai song song, theo dõi thông báo của nhà cung cấp và rà lại robots.txt định kỳ. Bài OpenAI ngừng huấn luyện trên internet “sống” giải thích thêm vì sao nguồn dữ liệu và môi trường thu thập ngày càng được tách bạch. Nếu cần hiểu cách AI dùng tài liệu tại thời điểm trả lời thay vì huấn luyện, bài RAG là gì sẽ dễ nối các khái niệm hơn.
Kết luận
Tín hiệu __usage_ai-training giúp website bày tỏ lựa chọn huấn luyện AI bằng cú pháp robots.txt quen thuộc. Disallow là phản đối, Allow là đồng ý, và có thể tạo ngoại lệ theo đường dẫn. Nó không tự chặn bot, không thay thế bảo vệ máy chủ và chưa khiến các điều khiển GPTBot hay Google-Extended trở nên thừa.
Trước khi sửa, hãy tách rõ tìm kiếm, grounding và huấn luyện. Sau khi sửa, đọc lại phản hồi thật từ website thay vì chỉ tin nút “đã lưu” trong trang quản trị. Một file vài dòng có thể dễ đọc, nhưng nếu đặt nhầm Disallow: / thì hậu quả SEO lại dài hơn file khá nhiều.
Nguồn tham khảo: OpenAI: Making it easier for websites to express AI training preferences; Google Search Central: Supporting a shared AI training control; Microsoft Bing: preferences for training and grounding; bản đầy đủ Internet-Draft; tài liệu crawler của OpenAI; tài liệu robots.txt của Cloudflare.