Dữ liệu riêng tư, bản quyền và thiên lệch khi dùng AI
Hướng dẫn phân loại dữ liệu đỏ, vàng, xanh; kiểm tra bản quyền, thử thiên lệch và giữ quyết định quan trọng ở phía con người khi dùng AI.
Bởi Võ Danh — 2 Tháng 10, 2026 trong Seri học AI từ cơ bản đến nâng cao
Bạn có thể dùng AI để sửa một email trong hai phút, rồi vô tình dán cả danh sách khách hàng vào ô chat trong hai giây. Phần nhanh là của máy. Phần chịu trách nhiệm vẫn là của người dùng.
Bài này gom ba chuyện thường bị tách rời: dữ liệu riêng tư, bản quyền và thiên lệch. Cả ba đều dẫn về một câu hỏi rất thực tế: trước khi nhập dữ liệu hoặc dùng đầu ra AI, mình đã biết ai có thể bị ảnh hưởng chưa?
Sau bài học, bạn có thể phân loại dữ liệu theo ba mức đỏ, vàng, xanh; kiểm tra quyền sử dụng nội dung; thử đầu ra với nhiều nhóm; và ghi rõ bước nào bắt buộc phải có người duyệt. Sản phẩm thực hành là một bảng quy tắc dùng AI cho chính công việc của bạn.
An toàn khi dùng AI bắt đầu từ dữ liệu đầu vào
Cửa sổ chat trông vô hại vì nó giống một ô tìm kiếm. Nhưng khi dán nội dung vào đó, bạn đang gửi dữ liệu tới một dịch vụ có chính sách lưu trữ, xử lý, chia sẻ và đào tạo mô hình riêng. Chính sách có thể khác giữa tài khoản cá nhân, tài khoản doanh nghiệp và API. Nút “xóa cuộc trò chuyện” cũng không tự động trả lời mọi câu hỏi về bản sao lưu, nhật ký hệ thống hay dữ liệu đã được dùng trong một quy trình khác.
NIST xếp quyền riêng tư dữ liệu vào nhóm rủi ro chính của AI tạo sinh. Tài liệu này cảnh báo mô hình có thể làm lộ, tạo ra hoặc suy luận thông tin nhạy cảm từ nhiều nguồn, kể cả khi người dùng không trực tiếp cung cấp toàn bộ thông tin đó.[3]
Ở Việt Nam, Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 có hiệu lực từ ngày 1/1/2026.[1] Luật nghiêm cấm xử lý dữ liệu cá nhân trái pháp luật, mua bán dữ liệu trái quy định, chiếm đoạt, cố ý làm lộ hoặc làm mất dữ liệu cá nhân.[2] Đây là mốc pháp lý cần biết, nhưng bài này không thay cho tư vấn pháp lý của đơn vị chuyên môn.
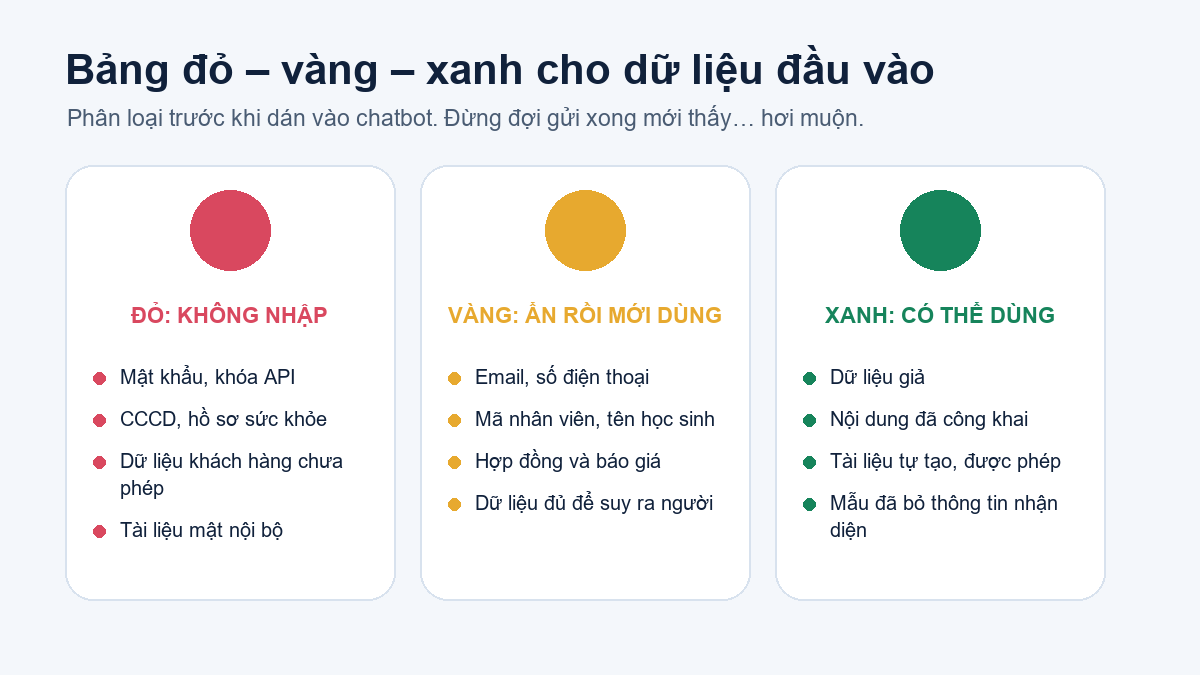
Trong công việc hằng ngày, cách phòng ngừa dễ nhớ nhất là không gửi dữ liệu thật nếu dữ liệu giả hoặc dữ liệu đã ẩn danh vẫn giải quyết được việc.
Dữ liệu đỏ: không nhập vào công cụ AI công cộng
Nhóm đỏ gồm mật khẩu, khóa API, mã khôi phục, số thẻ ngân hàng, hồ sơ sức khỏe, giấy tờ tùy thân, dữ liệu sinh trắc học, danh sách khách hàng chưa được phép xử lý và tài liệu mật nội bộ. Tệp Excel chỉ có mã khách hàng cũng chưa chắc an toàn. Nếu ghép mã đó với chi nhánh, số điện thoại, mức tiêu thụ hoặc lịch sử giao dịch, người ta có thể xác định lại một cá nhân.
Một quy tắc đủ thẳng: nếu dữ liệu lọt ra ngoài mà bạn phải gọi cho lãnh đạo, khách hàng hoặc bộ phận pháp chế để giải trình, đừng dán nó vào chatbot công cộng. Với môi trường học đường, UNESCO đã phát hành một hướng dẫn riêng về AI tạo sinh trong giáo dục và nghiên cứu từ năm 2023.[4]
Dữ liệu vàng: phải giảm thiểu và che thông tin nhận diện
Nhóm vàng là dữ liệu có ích cho nhiệm vụ nhưng đang chứa tên, email, số điện thoại, địa chỉ, mã nhân viên, tên học sinh, điều khoản hợp đồng hoặc số liệu kinh doanh chưa công bố. Bạn không cần bỏ cả nhiệm vụ. Hãy tạo một bản sao dành riêng cho AI:
- thay tên thật bằng nhãn như
KHACH_HANG_AhoặcHOC_SINH_01; - bỏ số điện thoại, email, địa chỉ và mã hồ sơ;
- đổi số liệu nhạy cảm thành dữ liệu mẫu có cùng cấu trúc;
- chỉ giữ những cột thật sự cần cho câu hỏi;
- kiểm tra lại xem các trường còn lại có thể ghép với nhau để nhận diện người hay không.
Ẩn tên nhưng để nguyên số hợp đồng, địa chỉ và ngày sinh không phải ẩn danh. Nó chỉ là chiếc áo khoác mỏng, gặp gió là lộ.
Dữ liệu xanh: vẫn phải kiểm tra quyền sử dụng
Nhóm xanh gồm dữ liệu giả, nội dung do bạn tự tạo, tài liệu đã công khai và tài liệu có giấy phép cho phép sử dụng theo mục đích đang làm. “Đã có trên mạng” không đồng nghĩa với “muốn dùng thế nào cũng được”. Một bài báo công khai vẫn có bản quyền. Một ảnh sản phẩm có thể được phép dùng cho báo chí nhưng không mặc nhiên được phép đưa vào quảng cáo.
Với tài liệu nội bộ, việc công ty đã mua quyền truy cập không có nghĩa mọi nhân viên được tải toàn bộ rồi gửi sang một dịch vụ bên ngoài. Hãy kiểm tra chính sách tổ chức, hợp đồng với nhà cung cấp và phạm vi quyền của tài khoản đang dùng.
Bản quyền: tách nguồn đầu vào khỏi quyền dùng đầu ra
Bản quyền quanh AI dễ rối vì có ít nhất hai câu hỏi khác nhau.
Câu hỏi thứ nhất: dữ liệu dùng để huấn luyện mô hình có được khai thác hợp pháp hay không? WIPO mô tả đây là vấn đề còn tranh luận giữa nhà phát triển và chủ sở hữu quyền. Cách xử lý khác nhau theo từng quốc gia, loại tác phẩm và hoàn cảnh sử dụng.[5]
Câu hỏi thứ hai gần với người dùng hơn: đầu ra do AI tạo ra có được bảo hộ, và có xâm phạm tác phẩm đã có hay không? Hai câu hỏi này không nên trộn thành một câu “AI có bản quyền hay không”.
Một ví dụ để thấy sự khác biệt giữa các hệ thống pháp luật: Văn phòng Bản quyền Hoa Kỳ cho biết đầu ra AI chỉ có thể được bảo hộ tại Hoa Kỳ khi con người quyết định đủ các yếu tố biểu đạt; chỉ viết prompt thường chưa đủ. Việc con người sắp xếp, sửa đổi hoặc kết hợp nội dung có thể được xem xét riêng.[6] Đây là quan điểm của Hoa Kỳ, không phải kết luận tự động áp dụng cho Việt Nam.
Về mặt thực hành, đừng dựa vào câu “AI tạo nên chắc không sao”. Trước khi dùng đầu ra để đăng bài, làm slide, chạy quảng cáo hoặc giao cho khách hàng, hãy kiểm tra bốn việc:
- Có đoạn văn, câu hát, nhân vật, logo hoặc bố cục nào giống rõ một tác phẩm cụ thể không?
- Prompt có yêu cầu bắt chước một nghệ sĩ, nhà văn hoặc thương hiệu đang hoạt động không?
- Tài liệu đầu vào có giấy phép cho phép sửa, tóm tắt, dịch hoặc dùng thương mại không?
- Bạn đã lưu nguồn, phiên bản gốc và phần chỉnh sửa do con người thực hiện chưa?
Nếu AI tạo một đoạn quá giống nguồn, hãy viết lại từ dữ kiện đã kiểm chứng, không chỉ đổi vài từ đồng nghĩa. Nếu dùng ảnh, nhạc hoặc mã nguồn, hãy kiểm tra giấy phép của từng tài sản. Nội dung đưa ra công chúng nên có hồ sơ nguồn đủ để một người khác lần lại được.
Thiên lệch không chỉ là câu trả lời “khó nghe”
Thiên lệch là xu hướng hệ thống tạo ra kết quả lệch theo một nhóm, ngôn ngữ, vùng miền hoặc kiểu dữ liệu. Nó có thể đến từ dữ liệu huấn luyện không đại diện, cách gắn nhãn, mục tiêu tối ưu, prompt của người dùng hoặc cách con người diễn giải kết quả.
NIST lưu ý AI tạo sinh có thể khuếch đại thiên lệch lịch sử và xã hội, tạo kết quả kém hơn cho một số nhóm hoặc ngôn ngữ, rồi dẫn tới quyết định thiếu công bằng nếu người dùng tin rằng mô hình hoạt động giống nhau với tất cả mọi người.[3]
Ví dụ, bạn nhờ AI sàng lọc hồ sơ ứng viên cho vị trí trực vận hành. Nếu dữ liệu cũ chủ yếu gồm một giới tính, một trường đào tạo hoặc một khu vực, mô hình có thể coi những đặc điểm đó là dấu hiệu “phù hợp” dù chúng không liên quan tới khả năng làm việc. Vấn đề không nằm ở một câu trả lời thiếu lịch sự. Vấn đề là sai lệch được nhân lên cho hàng trăm hồ sơ.
Thiên lệch cũng xuất hiện nhẹ hơn trong nội dung. Hãy yêu cầu AI viết ví dụ về một gia đình Việt Nam, rồi thử thay đổi vùng miền, độ tuổi, nghề nghiệp và hoàn cảnh kinh tế. Nếu nhân vật thành công luôn ở thành phố, dùng thiết bị đắt tiền và có một kiểu gia đình duy nhất, đầu ra đang thu hẹp thực tế.
Phép thử bốn biến thể
Khi đầu ra có thể ảnh hưởng tới con người, đừng kiểm tra bằng một prompt duy nhất. Hãy tạo ít nhất bốn biến thể:
- giữ nhiệm vụ, đổi tên và giới tính;
- đổi vùng miền hoặc cách dùng tiếng Việt;
- đổi độ tuổi hoặc điều kiện tiếp cận công nghệ;
- đổi thứ tự thông tin nhưng giữ nguyên năng lực cốt lõi.
Sau đó so sánh kết quả theo cùng một tiêu chí. Nếu điểm số, lời khuyên hoặc mức độ nghi ngờ thay đổi mạnh mà lý do không liên quan tới nhiệm vụ, bạn đã thấy một tín hiệu cần điều tra.
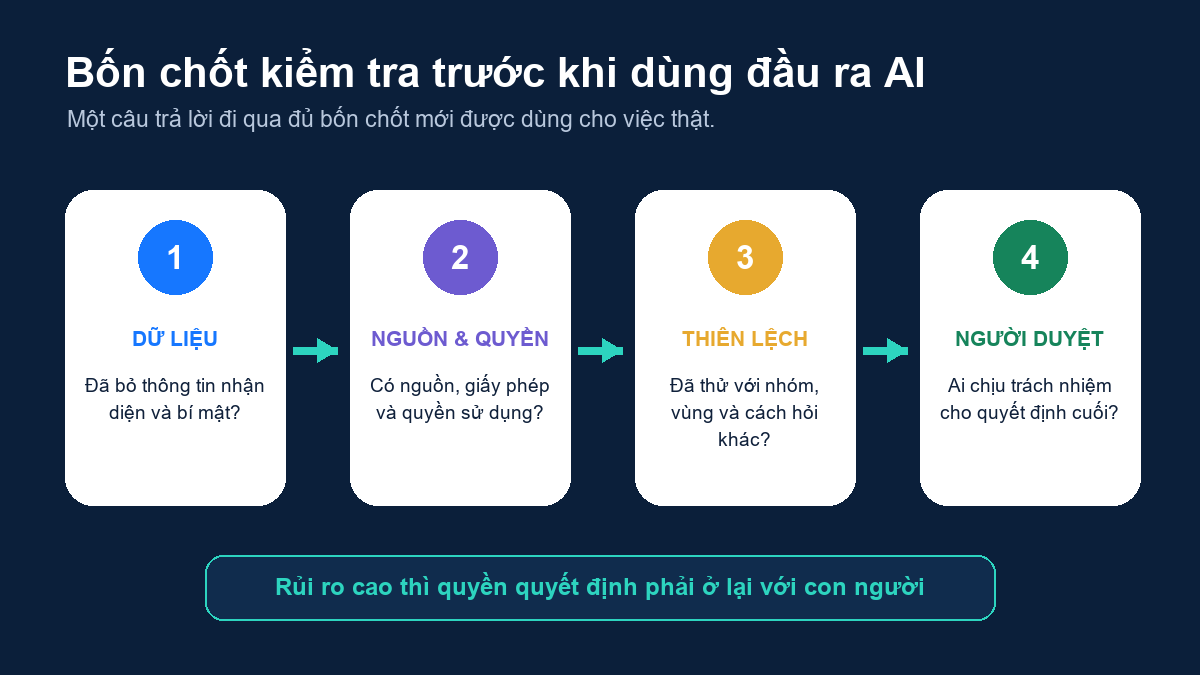
Một phép thử nhỏ không chứng minh hệ thống hoàn toàn công bằng. Nó chỉ giúp bắt những lỗi rõ trước khi lỗi đi xa. Với tuyển dụng, tín dụng, y tế, giáo dục, kỷ luật hoặc phân bổ quyền lợi, AI không nên là người quyết định cuối.
Thực hành: tạo bảng đỏ, vàng, xanh cho công việc của bạn
Chọn một việc bạn đang cân nhắc giao cho AI. Ví dụ: tóm tắt biên bản họp, viết email trả lời khách hàng, tạo câu hỏi ôn tập hoặc phân tích bảng sự cố.
Bước 1: ghi mục đích thật cụ thể
Đừng ghi “dùng AI để tăng năng suất”. Hãy ghi: “Tạo bản nháp email xác nhận lịch bảo trì từ dữ liệu mẫu, sau đó nhân viên phụ trách kiểm tra và gửi”. Câu này cho biết nhiệm vụ, dữ liệu, người duyệt và hành động cuối.
Bước 2: liệt kê dữ liệu đầu vào
Tách từng trường dữ liệu: tên khách hàng, địa chỉ, số điện thoại, mã thiết bị, lịch bảo trì, ghi chú kỹ thuật, nội dung hợp đồng. Đánh dấu ai là chủ thể dữ liệu và ai đang có quyền sử dụng.
Bước 3: xếp màu
- Đỏ: dữ liệu không được đưa vào công cụ đang dùng.
- Vàng: dữ liệu cần thay bằng nhãn, rút bớt hoặc tạo mẫu giả.
- Xanh: dữ liệu có thể dùng cho nhiệm vụ đã nêu, sau khi kiểm tra quyền.
Nếu còn phân vân giữa vàng và đỏ, chọn đỏ cho tới khi có người có thẩm quyền xác nhận. Chậm một nhịp vẫn rẻ hơn xử lý sự cố.
Bước 4: kiểm tra bản quyền và nguồn
Ghi nguồn của tài liệu, giấy phép hoặc căn cứ cho phép sử dụng. Nếu đầu ra sẽ công khai, thêm bước tìm đoạn trùng, logo, hình ảnh, trích dẫn và mã nguồn có thể cần xin phép hoặc ghi công.
Bước 5: thêm phép thử thiên lệch
Chọn hai đến bốn biến thể có liên quan tới người bị ảnh hưởng. Giữ nguyên tiêu chí nghiệp vụ. Ghi lại khác biệt và lý do chấp nhận hoặc từ chối.
Bước 6: đặt chốt con người
Chỉ rõ ai duyệt đầu ra. Người duyệt cần được xem dữ liệu gốc, tiêu chí và phần AI tạo ra. Với hành động gửi, đăng, xóa, chấm điểm hoặc từ chối một người, AI chỉ nên chuẩn bị đề xuất. Con người có trách nhiệm mới bấm nút cuối.
Mẫu sản phẩm bắt buộc
| Mục | Nội dung cần ghi |
|---|---|
| Nhiệm vụ | Một câu, có đầu ra cụ thể |
| Công cụ/tài khoản | Tên dịch vụ và loại tài khoản |
| Dữ liệu đỏ | Không nhập trong mọi trường hợp |
| Dữ liệu vàng | Cách ẩn, thay hoặc giảm bớt |
| Dữ liệu xanh | Nguồn và quyền sử dụng |
| Kiểm tra bản quyền | Nguồn, giấy phép, kiểm tra trùng |
| Kiểm tra thiên lệch | Các biến thể và tiêu chí so sánh |
| Người duyệt | Vai trò, không cần ghi tên thật |
| Dấu vết | Nơi lưu bản gốc, prompt, đầu ra và quyết định |
Những lỗi dễ gặp
Chỉ xóa tên rồi coi là an toàn. Nhiều trường còn lại vẫn đủ để nhận diện người. Hãy kiểm tra khả năng ghép nối dữ liệu.
Tin nhãn “do AI tạo” là giấy phép sử dụng. Nhãn này nói về cách tạo, không xác nhận đầu ra không giống tác phẩm khác và cũng không cấp quyền cho tài liệu đầu vào.
Thử thiên lệch bằng cảm giác. Một câu trả lời trông trung lập chưa đủ. Cần biến thể đầu vào và tiêu chí so sánh cố định.
Để người duyệt chỉ nhìn bản tóm tắt của AI. Khi không thấy nguồn gốc, người duyệt dễ ký vào một kết luận mà không có bằng chứng.
Dùng tài khoản cá nhân cho dữ liệu công việc. Tài khoản doanh nghiệp có thể có điều khoản và kiểm soát khác. Hãy dùng đúng môi trường đã được tổ chức phê duyệt.
Tự kiểm tra nhanh
-
Dữ liệu nào nên được xếp đỏ ngay?
A. Văn bản do bạn tự viết. B. Khóa API. C. Dữ liệu giả. D. Tài liệu công khai có giấy phép. -
Xóa tên khỏi bảng dữ liệu đã đủ ẩn danh chưa?
A. Luôn đủ. B. Chưa chắc, vì các trường khác có thể ghép để nhận diện. C. Chỉ cần đổi tên tệp. D. Có, nếu dùng AI trả phí. -
Đầu ra gắn nhãn “AI-generated” có mặc nhiên được dùng thương mại không?
A. Có. B. Không, vẫn phải kiểm tra nguồn, giấy phép và luật áp dụng. C. Chỉ ảnh mới cần kiểm tra. D. Chỉ văn bản mới cần kiểm tra. -
Cách thử thiên lệch tốt hơn là gì?
A. Hỏi lại y hệt nhiều lần. B. Đổi các thuộc tính không liên quan tới năng lực và so theo cùng tiêu chí. C. Chọn câu trả lời dài nhất. D. Tin vào cảnh báo của mô hình. -
Ai quyết định cuối trong việc có hậu quả cao?
A. AI. B. Người có trách nhiệm và đủ thông tin để duyệt. C. Người nhập prompt nhanh nhất. D. Không cần ai nếu mô hình tự tin.
Đáp án: 1B, 2B, 3B, 4B, 5B.
Rubric chấm sản phẩm: đạt từ 75%
Tự chấm theo bốn tiêu chí, mỗi tiêu chí 25 điểm:
- Đúng mục tiêu: nhiệm vụ, đầu ra và người duyệt được ghi rõ.
- Kiểm chứng được: có nguồn, giấy phép, phép thử thiên lệch và dấu vết quyết định.
- An toàn dữ liệu: dữ liệu đỏ, vàng, xanh được phân loại; dữ liệu vàng có cách xử lý cụ thể.
- Dùng lại được: đồng nghiệp khác có thể áp dụng bảng này mà không phải đoán.
Từ 75 điểm trở lên là đạt. Nếu tiêu chí an toàn dữ liệu dưới 15 điểm, hãy sửa trước dù tổng điểm có vẻ đủ. Điểm số không nên trở thành tấm màn che một lỗ hổng rõ ràng.
Bước kiểm chứng và an toàn trước khi dùng thật
Chạy thử quy trình bằng dữ liệu giả. Kiểm tra lịch sử trò chuyện, bộ nhớ, quyền chia sẻ, chính sách lưu dữ liệu và tùy chọn dùng nội dung để cải thiện mô hình của đúng dịch vụ, đúng loại tài khoản. Sau đó nhờ một người không tham gia soạn bảng đọc lại. Nếu họ không biết dữ liệu nào được nhập hoặc ai duyệt, tài liệu chưa sẵn sàng.
Khi phát hiện đã gửi nhầm dữ liệu nhạy cảm, đừng chỉ xóa cuộc trò chuyện rồi coi như xong. Hãy dừng chia sẻ, lưu lại thời điểm và phạm vi sự cố, báo cho đầu mối bảo mật hoặc quản lý dữ liệu của tổ chức, rồi làm theo quy trình ứng phó đã có.
Học tiếp trong series
Bài trước: Kiểm chứng câu trả lời AI: ảo giác, nguồn và phép thử chéo.
Xem toàn bộ bài đã xuất bản trong Seri học AI từ cơ bản đến nâng cao.
Bài tiếp theo dự kiến là “Dùng AI với văn bản, hình ảnh, âm thanh và bảng dữ liệu”. Trước khi học bài đó, hãy hoàn thành bảng đỏ, vàng, xanh. Nó là cái phanh cần có trước khi chúng ta tăng tốc với nhiều loại dữ liệu hơn.
Nguồn tham khảo
- [1] Luật số 91/2025/QH15: Luật Bảo vệ dữ liệu cá nhân
- [2] Cổng TTĐT Chính phủ: Những quy định đáng chú ý trong Luật Bảo vệ dữ liệu cá nhân 2025
- [3] NIST AI 600-1: Generative AI Profile
- [4] UNESCO: Guidance for generative AI in education and research
- [5] WIPO: The AI and IP landscape
- [6] U.S. Copyright Office: Copyrightability of AI outputs