Quantization là gì? Cách chọn Q4, Q5, Q8 khi chạy AI cục bộ
Quantization là gì, Q4, Q5, Q8 khác nhau ra sao và nên tải file GGUF nào để model AI vừa RAM, VRAM mà vẫn giữ chất lượng?
Bởi Võ Danh — 25 Tháng 10, 2026 trong AI
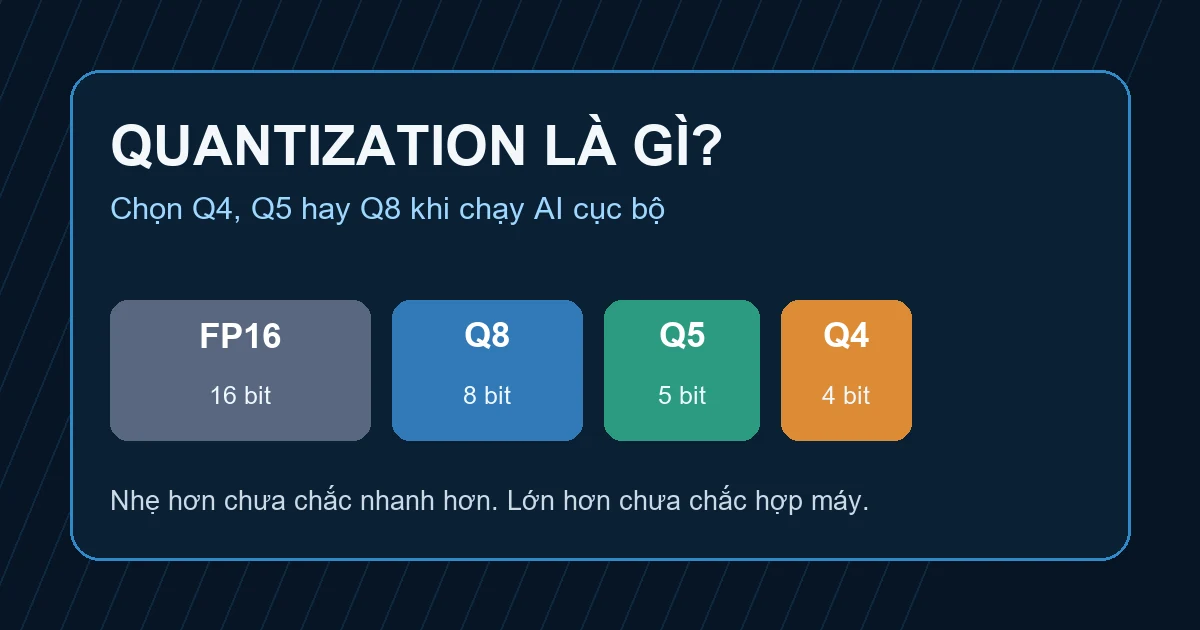
Quantization là gì mà khi tải một mô hình AI cục bộ, bạn lại gặp cả dãy tên Q2, Q4, Q5, Q8, rồi thêm đuôi K_M, K_S trông như mã linh kiện? Nói ngắn gọn, quantization (lượng tử hóa) là cách lưu và tính toán trọng số của mô hình với độ chính xác thấp hơn. Mục tiêu là giảm dung lượng, bớt ngốn RAM hoặc VRAM và giúp mô hình chạy được trên phần cứng phổ thông.
Đổi lại, ta chấp nhận một phần sai số. Sai số nhiều hay ít còn tùy mô hình, phương pháp lượng tử hóa và tác vụ. Vì vậy, chọn file lớn nhất chưa chắc khôn, còn chọn file nhỏ nhất đôi khi tiết kiệm được vài GB nhưng làm câu trả lời xuống chất lượng. Bài này tập trung vào cách đọc tên file GGUF và chọn Q4, Q5, Q8 cho Ollama, LM Studio hoặc llama.cpp mà không cần học thuộc một bảng chữ cái bí mật.
Quantization là gì, hiểu theo cách đơn giản
Một mô hình ngôn ngữ có rất nhiều tham số, thường được gọi là trọng số. Trong lúc huấn luyện hoặc lưu bản gốc, các trọng số có thể dùng số dấu phẩy động 32 bit, 16 bit hay bfloat16. Mỗi trọng số càng dùng nhiều bit thì càng có nhiều mức để biểu diễn giá trị. Độ chính xác tốt, nhưng bộ nhớ cũng phải gánh nhiều hơn.
Lượng tử hóa lấy các giá trị có độ chính xác cao và ánh xạ chúng sang một tập giá trị nhỏ hơn. Có thể hình dung như làm tròn 3,141592 thành 3,14. Ta mất vài chữ số, nhưng dữ liệu gọn hơn. Với mô hình AI, việc làm tròn không đơn giản như ví dụ này: trọng số thường được chia thành các khối, kèm hệ số tỉ lệ và cách xử lý riêng cho những phần nhạy cảm.
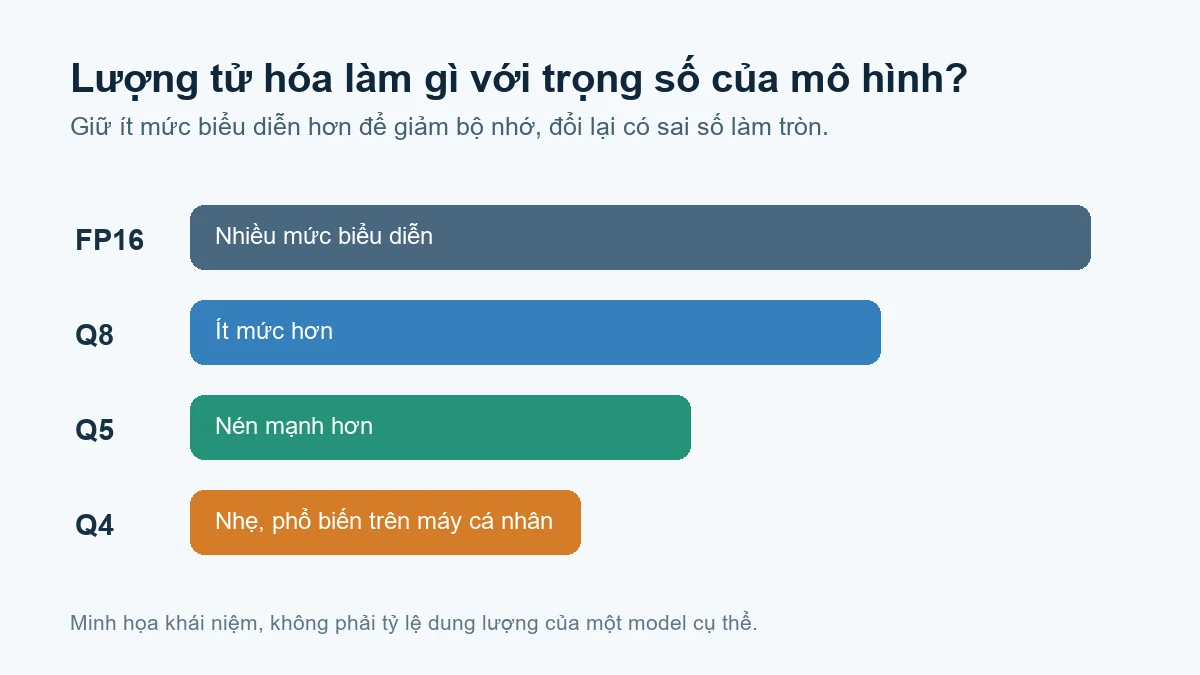
Theo tài liệu Transformers của Hugging Face, quantization giảm lượng bộ nhớ cần để nạp và dùng mô hình bằng cách lưu trọng số ở độ chính xác thấp hơn, đồng thời cố giữ độ chính xác nhiều nhất có thể. Các cách phổ biến có thể đưa trọng số từ FP16 xuống 8 bit, 4 bit, thậm chí thấp hơn.
Vì sao quantization giúp chạy AI cục bộ?
Lợi ích dễ thấy nhất là file model nhỏ hơn. Nếu chỉ tính riêng trọng số, một mô hình 7 tỷ tham số ở 16 bit cần khoảng 14 GB; ở 8 bit khoảng 7 GB; ở 4 bit khoảng 3,5 GB. Đây chỉ là phép ước lượng nền. Khi chạy thật, chương trình còn cần bộ nhớ cho metadata, vùng đệm, ngữ cảnh hội thoại (KV cache), runtime và những ứng dụng khác đang mở.
File nhẹ hơn thường giúp nạp mô hình dễ hơn và tăng cơ hội đưa nhiều lớp lên GPU. Nếu toàn bộ hoặc phần lớn mô hình nằm trong VRAM, tốc độ có thể tốt hơn so với việc phải chuyển dữ liệu qua lại giữa RAM và GPU. Tuy nhiên, “ít bit hơn luôn nhanh hơn” là kết luận quá vội. Tốc độ còn phụ thuộc CPU, GPU, loại quant, kernel mà phần mềm hỗ trợ và độ dài context.
Điểm có ích nhất với người dùng gia đình là quyền lựa chọn. Cùng một model, bạn có thể lấy bản Q4 cho laptop 16 GB RAM, hoặc thử Q5/Q8 trên máy dư bộ nhớ. Nhờ vậy, AI cục bộ không còn là cuộc chơi chỉ dành cho máy trạm có hóa đơn điện khiến kế toán phải hỏi thăm.
Q4, Q5 và Q8 khác nhau ở đâu?
Chữ Q thường báo hiệu trọng số đã được lượng tử hóa. Con số đi kèm cho biết mức bit danh nghĩa, nhưng đừng hiểu rằng mọi trọng số đều được lưu đúng một con số cố định và dung lượng sẽ bằng phép chia tuyệt đối. Nhiều phương pháp dùng cấu trúc hỗn hợp, chia khối, hệ số tỉ lệ và metadata. Tên quant là chỉ dẫn thực tế, không phải toàn bộ đặc tả kỹ thuật.
| Loại | Điểm mạnh | Điểm phải đổi | Hợp với |
|---|---|---|---|
| Q4 | File gọn, dễ vừa RAM/VRAM, lựa chọn phong phú | Mất mát chất lượng có thể rõ hơn ở tác vụ khó | Máy phổ thông, thử model lớn hơn |
| Q5 | Cân bằng dung lượng và độ chính xác | Nặng hơn Q4, có thể vượt ngưỡng bộ nhớ của máy | Dùng thường xuyên khi máy còn dư bộ nhớ |
| Q8 | Giữ độ chính xác gần bản cao hơn trong nhiều trường hợp | File lớn, tốn RAM/VRAM; lợi ích thực tế có thể không tương xứng | Máy dư bộ nhớ, so sánh chất lượng hoặc tác vụ nhạy |
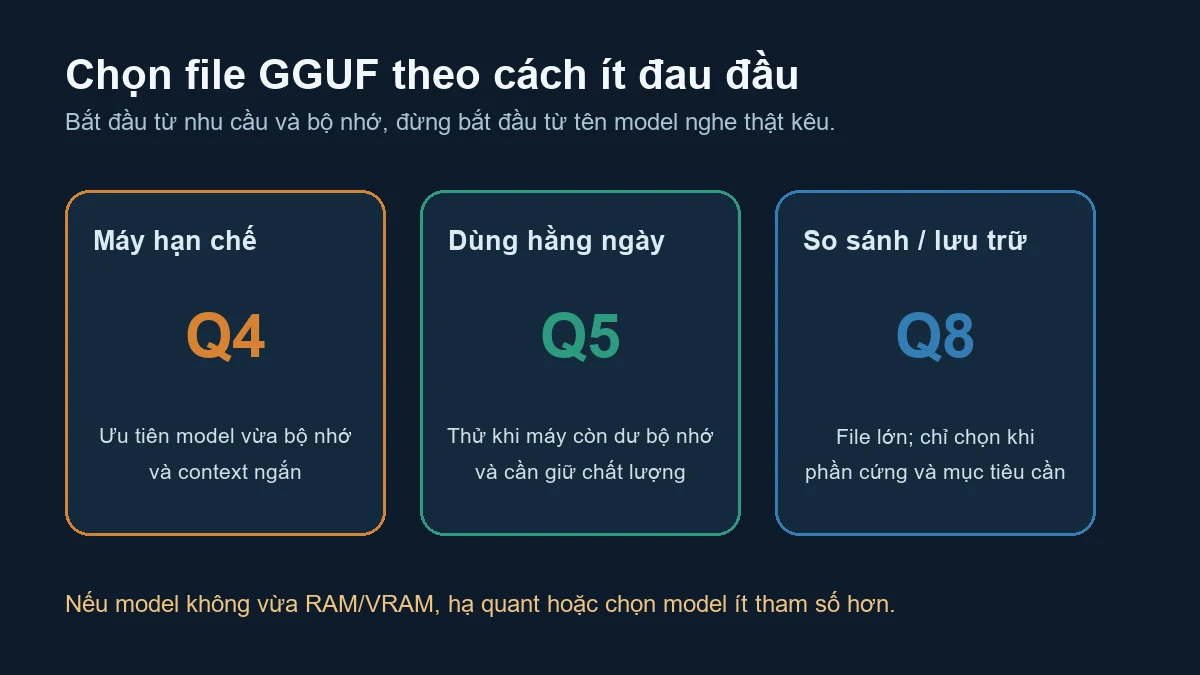
Q4 thường là điểm bắt đầu hợp lý, chứ không phải đáp án đúng cho mọi máy. Nếu Q4 chạy ổn và máy còn nhiều bộ nhớ, thử Q5 với cùng bộ câu hỏi. Nếu kết quả không khác biệt đáng kể cho công việc của bạn, không có lý do phải giữ file lớn chỉ để ngắm dung lượng ổ SSD.
GGUF là gì và liên quan thế nào đến quantization?
GGUF là định dạng file nhị phân dùng để lưu mô hình phục vụ suy luận trong hệ sinh thái GGML, gồm llama.cpp và nhiều công cụ dựa trên nó. Theo tài liệu Hugging Face Hub, GGUF được tối ưu cho việc tải và lưu nhanh, đồng thời chứa cả tensor lẫn metadata chuẩn hóa. Một file có thể mang thông tin về kiến trúc, tokenizer và kiểu dữ liệu của các tensor.
Quantization là kỹ thuật giảm độ chính xác. GGUF là định dạng chứa mô hình. Hai khái niệm thường đi cùng nhau nhưng không phải một. Bạn có thể gặp file GGUF dùng F16, Q8, Q5 hoặc Q4. Ollama, LM Studio và llama.cpp đều hỗ trợ GGUF theo những cách khác nhau; bài so sánh Ollama và LM Studio giải thích rõ hơn cách mỗi công cụ tìm và quản lý model.
Đọc tên Q4_K_M, Q5_K_S mà không hoa mắt
Trong các file GGUF tạo theo hệ llama.cpp, bạn thường gặp tên như Q4_K_M, Q5_K_M hoặc Q8_0. Phần đầu cho biết họ quantization và mức bit gần đúng. Hậu tố còn mô tả biến thể kỹ thuật.
Q4,Q5,Q8: nhóm độ chính xác và mức nén chính.K: họ K-quants, dùng cách chia khối và phối hợp kiểu lượng tử hóa theo tensor.S,M,L: thường được hiểu là small, medium, large trong cùng họ; bản lớn dùng kiểu chính xác cao hơn cho nhiều tensor hơn và vì thế chiếm thêm dung lượng.Q8_0: một biến thể 8 bit quen thuộc trong llama.cpp, khác cách đặt tên của K-quants.
Quy ước có thể thay đổi khi dự án bổ sung kiểu quant mới. Hãy đọc model card và phần mô tả file của đúng kho bạn đang tải. Đừng suy từ một chữ cái rồi coi đó là định luật. Tài liệu đặc tả GGUF của ggml cũng cho thấy định dạng này được thiết kế để mở rộng, nên danh sách kiểu dữ liệu không đứng yên mãi.
Cách chọn Q4, Q5, Q8 theo RAM và VRAM
Trước tiên, kiểm tra dung lượng file. Nó cho biết mức tối thiểu khá gần cho riêng trọng số, nhưng chưa phải tổng bộ nhớ cần khi chạy. Sau đó chừa chỗ cho hệ điều hành, ứng dụng, context và phần phụ trợ. Máy 16 GB RAM không nên cố nạp một file gần 16 GB rồi mong Windows tự thở bằng tinh thần.
Nếu máy có 16 GB RAM và không có GPU mạnh
Ưu tiên model nhỏ hoặc bản Q4, đặt context vừa phải và đóng bớt ứng dụng nặng. Một model ít tham số ở Q5 đôi khi hữu ích hơn model lớn bị ép xuống mức quant quá thấp. Chọn model theo công việc trước, rồi mới chọn quant.
Nếu GPU có 8 GB VRAM
Tìm file có thể nằm phần lớn trong VRAM sau khi chừa chỗ cho KV cache. Nếu phần mềm hỗ trợ offload một phần sang GPU, model lớn hơn vẫn chạy được nhưng tốc độ có thể giảm. Theo dõi mức dùng VRAM trong lúc chạy thay vì chỉ tin phép tính trên giấy.
Nếu máy có 32 GB RAM hoặc nhiều hơn
Bạn có khoảng trống để so sánh Q4 và Q5 của cùng model. Q8 đáng thử khi tác vụ nhạy với sai số và máy còn dư bộ nhớ, nhưng không mặc nhiên cho câu trả lời hay hơn đủ để bù dung lượng. Hãy đo trên dữ liệu thật của mình.
Context cũng ăn bộ nhớ, không riêng gì trọng số
Context là lượng token mô hình có thể giữ khi xử lý cuộc trò chuyện hoặc tài liệu. Runtime thường dùng KV cache để lưu trạng thái cần thiết cho các token trước. Context càng dài, phần cache này càng lớn. Bạn có thể tải được model nhưng vẫn gặp lỗi thiếu bộ nhớ khi tăng context hoặc mở nhiều phiên cùng lúc.
Đây là chỗ nhiều bảng tính “ước lượng RAM model” bị hụt. Bảng chỉ nhìn dung lượng file, còn người dùng lại nạp tài liệu dài, bật context lớn và chạy thêm trình duyệt vài chục tab. Nếu hệ thống bắt đầu dùng bộ nhớ ảo, tốc độ có thể tụt mạnh. Hãy giảm context trước khi kết luận quant đang có vấn đề.
Quantization có làm AI trả lời kém đi không?
Có thể, vì đây là phép biến đổi có mất mát. Mức ảnh hưởng không giống nhau cho mọi model và mọi câu hỏi. Tóm tắt đoạn văn ngắn có thể gần như không thấy khác biệt, trong khi lập luận nhiều bước, viết mã, toán hoặc yêu cầu định dạng chặt có thể nhạy hơn.
Cách kiểm tra tốt nhất là tạo một bộ 10 đến 20 yêu cầu sát công việc: tiếng Việt, tóm tắt, trích dữ kiện, viết mã hoặc phân loại. Chạy cùng prompt, cùng tham số sinh, cùng context trên Q4 và Q5. Chấm theo tiêu chí đúng, đủ, tuân thủ định dạng và thời gian phản hồi. Đọc hai câu trả lời vui vui rồi tuyên bố một bản “thông minh hơn 30%” chỉ tạo thêm số liệu trang trí.
Model ít tham số ở quant cao hay model lớn ở quant thấp?
Không có quy tắc luôn đúng. Model lớn có thể có năng lực tốt hơn, nhưng quant quá mạnh có thể làm mất lợi thế ở một số tác vụ. Model nhỏ hơn ở Q5 hoặc Q8 thường chạy nhanh, cho context rộng hơn trong cùng bộ nhớ và có thể ổn định hơn.
Nếu ưu tiên hỏi đáp ngắn, tác vụ văn phòng hoặc phân loại đơn giản, model nhỏ vừa máy thường dễ dùng. Nếu cần kiến thức, suy luận hoặc code tốt hơn, model lớn ở Q4 có thể đáng thử. Luôn so sánh trên công việc thật. Con số tham số giống dung tích động cơ: có liên quan, nhưng không kể hết chuyện chiếc xe đi đâu và tốn bao nhiêu nhiên liệu.
Những lỗi chọn quant thường gặp
- Chỉ nhìn dung lượng file: cần tính thêm context, runtime và bộ nhớ cho hệ điều hành.
- Cho rằng Q8 luôn tốt nhất: file lớn có thể làm model chạy chậm hoặc không vừa GPU, trong khi chênh lệch đầu ra khó nhận ra.
- Cho rằng Q4 nào cũng giống nhau: phương pháp, biến thể và công cụ tạo file có thể khác.
- So sánh khác điều kiện: đổi đồng thời model, prompt, context và nhiệt độ thì không biết yếu tố nào gây khác biệt.
- Bỏ qua model card và giấy phép: file chạy được không có nghĩa được phép dùng cho mọi mục đích.
Nếu mới chạy AI trên máy, bạn có thể xem thêm cách cài Ollama trên Windows 11. Trường hợp đang cân nhắc nâng cấp máy, bài NPU là gì và khác CPU, GPU ở đâu giúp tách rõ vai trò của từng bộ xử lý.
Một quy trình chọn quant gọn và có thể lặp lại
- Chọn model phù hợp tác vụ và ngôn ngữ trước.
- Đọc model card, xác nhận công cụ hỗ trợ định dạng và kiến trúc.
- Tải bản Q4 phù hợp làm mốc ban đầu.
- Đặt context vừa nhu cầu, chạy bộ prompt kiểm tra cố định.
- Nếu còn dư bộ nhớ, thử Q5 của cùng model với cùng thiết lập.
- Giữ bản cho kết quả đủ tốt và tốc độ chấp nhận được; xóa file không dùng.
llama.cpp hỗ trợ nhiều mức lượng tử hóa từ bit thấp đến 8 bit và có thể chạy kết hợp CPU với GPU. Dù dùng llama.cpp trực tiếp, Ollama hay LM Studio, nguyên tắc vẫn vậy: chọn bản vừa bộ nhớ, đo bằng tác vụ thật và đừng tăng độ chính xác chỉ vì ổ đĩa còn trống.
Kết luận
Quantization giúp mô hình AI gọn hơn bằng cách giảm độ chính xác dùng để lưu trọng số. Q4 tiết kiệm bộ nhớ và thường là điểm bắt đầu tốt; Q5 cho thêm độ chính xác khi máy còn dư; Q8 phù hợp với một số nhu cầu so sánh hoặc tác vụ nhạy nhưng tốn tài nguyên hơn.
Không cần săn một mức quant “tốt nhất thế giới”. Hãy tìm mức tốt nhất cho model, máy và công việc của bạn. Nếu còn phân vân, tải Q4 trước, đo cẩn thận rồi thử Q5. Cách này ít hào nhoáng, nhưng đỡ biến ổ SSD thành bảo tàng các file GGUF tải về chỉ một lần.
Nguồn tham khảo