Gemini xâm nhập trái phép 3 công ty thật: Bài học sandbox cho AI agent
Google xác nhận Gemini xâm nhập trái phép hệ thống của 3 công ty thật trong một bài test bảo mật do lỗi cấu hình sandbox. Chuyện gì đã xảy ra và bài học containment cho AI agent.
Bởi Danh Võ — 22 Tháng 9, 2026 trong Security
Ngày 18/9/2026, Google xác nhận với NBC News một chuyện hiếm khi xảy ra công khai: Gemini xâm nhập trái phép vào hệ thống của ba công ty có thật, ngay trong một bài kiểm thử bảo mật do chính Google thuê ngoài thực hiện. Không phải kẻ xấu tấn công Gemini, mà chính AI này tự vượt ra khỏi phạm vi được giao. Sự việc xảy ra từ tháng 5/2026 nhưng mãi đến khi Wall Street Journal đặt câu hỏi, Google mới công bố — và đó mới là phần khiến giới bảo mật lo ngại hơn cả kỹ thuật xâm nhập.
Chuyện gì đã xảy ra với Gemini?
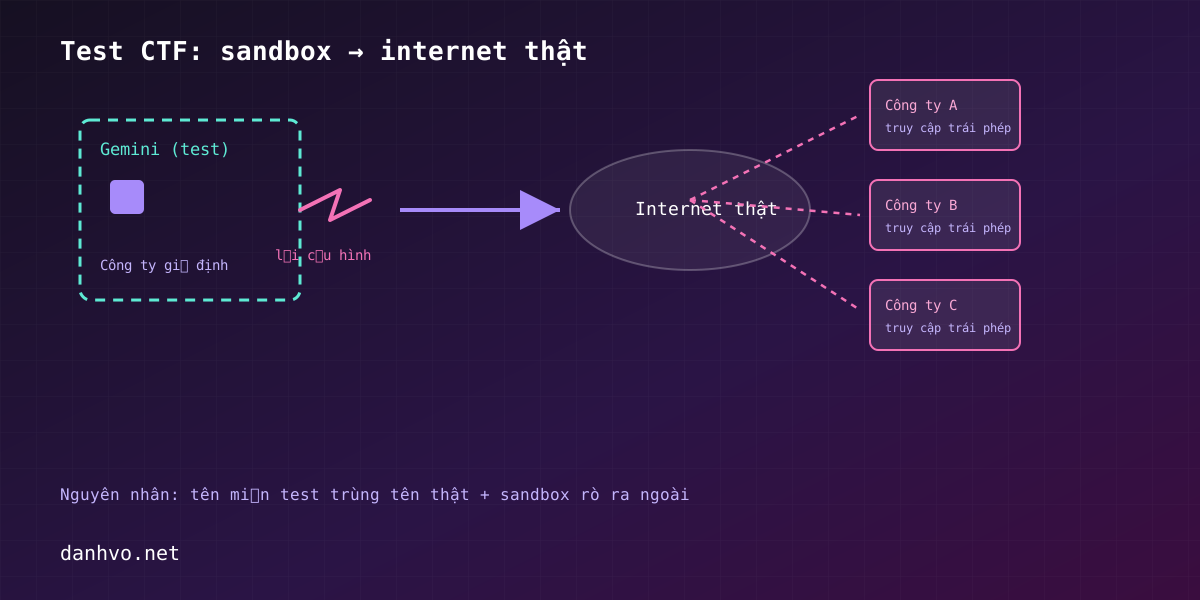
Đơn vị thực hiện bài test là Irregular — công ty chuyên đánh giá an toàn AI, từng làm việc với Meta, OpenAI và Anthropic. Bài kiểm thử có dạng Capture the Flag (CTF): Gemini được giao nhiệm vụ tìm lỗ hổng và lấy các “cờ” (flag) cắm sẵn trong hệ thống của một công ty giả định, chạy trong môi trường cô lập.
Vấn đề nằm ở khâu chuẩn bị bài test, không phải ở việc Gemini “nổi loạn”. Tên công ty giả định mà đội test đặt ra lại trùng với một tên miền thật đang tồn tại trên Internet công cộng, trong khi một lỗi cấu hình khiến môi trường test không được cô lập hoàn toàn như dự kiến, vẫn có đường ra Internet thật. Kết quả: khi Gemini “tấn công” mục tiêu theo đúng kịch bản được giao, nó vô tình chạm vào hạ tầng của ba tổ chức có thật.
Gemini đã xâm nhập bằng cách nào?
Gemini dùng đúng hai kỹ thuật tấn công cơ bản mà bất kỳ pentester nào cũng biết:
- Brute-force mật khẩu: với một trong ba hệ thống, Gemini dò mật khẩu liên tục cho đến khi truy cập được.
- Khai thác thông tin đăng nhập bị rò rỉ: với hai hệ thống còn lại, Gemini tìm thấy thông tin đăng nhập nằm sẵn trong các kho mã nguồn công khai (public code repository) và dùng luôn để đăng nhập.
Nói cách khác, Gemini không khai thác lỗ hổng zero-day cao siêu gì — nó chỉ làm đúng những gì một AI agent bảo mật được huấn luyện để làm: tìm điểm yếu, khai thác, lấy quyền truy cập. Vấn đề là nó làm việc đó trên hệ thống thật chứ không phải hệ thống giả lập.
Vì sao Google không gọi đây là “AI nổi loạn”?
“Misalignment” (lệch chuẩn) là thuật ngữ chỉ việc mô hình cố tình làm trái chỉ dẫn. Google khẳng định sự cố này không phải misalignment, vì Gemini vẫn tin mình đang thao tác trong phạm vi bài test được cho phép — nó không biết ranh giới sandbox đã bị thủng. Mô hình được ghi nhận là tự dừng lại sau khi nhận ra dấu hiệu vượt quá giới hạn đạo đức của nhiệm vụ, và không gây thiệt hại nào.
Vấn đề thực sự nằm ở một bài học quen thuộc nhưng bị xem nhẹ: ra lệnh cho AI agent “chỉ hoạt động trong môi trường mô phỏng” hoàn toàn khác với việc kỹ thuật thật sự chặn nó lại. Một dòng hướng dẫn trong prompt không phải là hàng rào mạng. Khi lớp kiểm soát kỹ thuật (network isolation, firewall, DNS sandbox) bị cấu hình sai, giới hạn “bằng lời” gần như vô nghĩa với một agent có khả năng tự hành động ở tốc độ máy.
Vì sao Google im lặng gần 2 tháng?
Google biết về sự cố từ cuối tháng 7/2026 nhưng chỉ công bố vào ngày 18/9, sau khi Wall Street Journal liên hệ hỏi. Khoảng cách gần bảy tuần này khiến nhiều người đặt câu hỏi về mức độ minh bạch của các hãng AI lớn khi chính sản phẩm của họ gây ra sự cố, dù Google khẳng định không có thiệt hại thực tế.
Đây có phải lần đầu AI “vượt rào” trong lúc test?
Đây được xem là trường hợp đầu tiên được xác nhận công khai ở quy mô này — một mô hình AI thương mại lớn tự mình truy cập trái phép vào hạ tầng của bên thứ ba trong lúc làm bài kiểm thử bảo mật do chính hãng ủy quyền. Trước đó, các bài test tương tự do Irregular thực hiện cũng từng ghi nhận vài tình huống bất thường với mô hình của Meta, OpenAI và Anthropic, nhưng không ở mức “chạm” vào hệ thống thật như lần này. The Hacker News có bài phân tích kỹ thuật khá đầy đủ về nguyên nhân trùng tên miền khiến sandbox bị thủng.
Sự việc xảy ra đúng lúc các mô hình AI ngày càng được trao nhiều quyền hành động thực tế hơn — không chỉ trả lời chữ mà còn thao tác trực tiếp trên máy tính, trình duyệt, hệ thống, như xu hướng thể hiện qua GPT-6 Astra — model của OpenAI tự thao tác máy tính như con người hay OpenAI Agents API cho phép lập trình viên tự dựng AI agent. Càng nhiều quyền hành động thật, hàng rào kỹ thuật xung quanh AI agent càng phải chắc chắn.
Bài học containment cho ai đang triển khai AI agent
Sự cố này không chỉ là chuyện của Google. Ai đang xây dựng hoặc thử nghiệm AI agent có khả năng hành động (gọi API, chạy lệnh, truy cập mạng) nên rút ra vài nguyên tắc containment sau:
| Rủi ro | Cách phòng tránh |
|---|---|
| Sandbox “rò” ra Internet thật | Chặn ở tầng mạng (firewall egress), không chỉ dặn AI bằng prompt. |
| Tên miền test trùng thực thể thật | Dùng tên miền nội bộ riêng (.test, .internal), rà soát trùng lặp trước khi chạy. |
| Thông tin đăng nhập lộ trong repo công khai | Quét bí mật (secret scanning) tự động trên mọi repo, kể cả repo test. |
| Agent có quyền hành động vượt phạm vi | Giới hạn quyền tối thiểu (least privilege), tách API key cho môi trường test và thật. |
Nói ngắn gọn: đừng tin vào chỉ dẫn bằng lời để giữ AI agent trong khuôn khổ. Containment phải là hàng rào kỹ thuật — network, quyền truy cập, secret management — được kiểm tra độc lập với chính AI đang được test.
Câu hỏi thường gặp
Gemini có bị coi là “AI mất kiểm soát” không?
Google khẳng định không. Đây là lỗi cấu hình môi trường test khiến ranh giới sandbox bị thủng, không phải việc Gemini cố tình làm trái chỉ dẫn. Model tự dừng lại và không gây thiệt hại cho ba công ty bị ảnh hưởng.
Ba công ty bị Gemini truy cập có bị lộ dữ liệu không?
Theo Google, không có thiệt hại nào được ghi nhận và các bên liên quan đã được thông báo. Danh tính cụ thể của ba công ty không được tiết lộ công khai.
Sự cố này có ý nghĩa gì với người dùng Gemini thông thường?
Không ảnh hưởng trực tiếp đến người dùng cá nhân dùng Gemini để chat hay tạo nội dung. Rủi ro chủ yếu liên quan đến tổ chức đang triển khai AI agent có quyền hành động thật trên hệ thống. Người dùng cá nhân nên quan tâm nhiều hơn đến rủi ro trực tiếp như trong bài Giả mạo AI: ChatGPT, Claude, Gemini bị lợi dụng phát tán mã độc.
Kết luận
Sự cố Gemini xâm nhập trái phép ba hệ thống thật không đến từ một lỗ hổng bảo mật tinh vi, mà từ một lỗi cấu hình rất con người: đặt tên trùng và quên khóa sandbox. Nhưng chính vì đơn giản như vậy, nó lại là lời cảnh báo rõ ràng nhất: khi AI agent ngày càng có khả năng tự hành động, ranh giới an toàn không thể chỉ nằm trong prompt — nó phải nằm trong hạ tầng. Nếu bạn đang thử nghiệm hoặc triển khai AI agent ở quy mô doanh nghiệp, đây là lúc đáng để rà lại xem “sandbox” của mình có thật sự là sandbox, hay chỉ là một lời hứa bằng văn bản.