Context window là gì? Vì sao AI quên và dài hơn chưa chắc tốt hơn
Context window là bộ nhớ làm việc của mô hình AI. Hiểu token, lý do AI quên và cách quản lý ngữ cảnh dài để trả lời đúng, nhanh, đỡ tốn phí.
Bởi Võ Danh — 11 Tháng 10, 2026 trong AI
Context window là gì mà cứ mỗi lần hãng AI ra model mới, người ta lại mang số token ra so? Hiểu ngắn gọn, đây là lượng thông tin mô hình có thể xem xét trong một lần xử lý. Nó giống bộ nhớ làm việc hơn là trí nhớ lâu dài: có câu hỏi hiện tại, lịch sử trò chuyện, tài liệu đính kèm, hướng dẫn hệ thống và cả phần trả lời sắp được tạo.
Context window lớn cho phép AI đọc tài liệu dài hơn hoặc theo dõi cuộc trò chuyện lâu hơn. Nhưng con số lớn không bảo đảm câu trả lời hay. Nếu đưa vào một đống dữ liệu lẫn lộn, mô hình vẫn có thể bỏ sót chi tiết, bám nhầm đoạn hoặc tốn thêm tiền API. Cái khó không nằm ở việc nhét được bao nhiêu, mà là chọn phần nào thật sự cần.
Bài này giải thích token, cửa sổ ngữ cảnh, lý do AI “quên”, cách ước lượng dung lượng và cách dùng ngữ cảnh dài cho công việc hàng ngày. Không cần học toán cao cấp. Chỉ cần nhớ một nguyên tắc: bàn làm việc rộng đến đâu mà chất kín giấy thì vẫn khó tìm đúng tờ cần dùng.
Context window là gì?
Trong mô hình ngôn ngữ lớn, context window hay cửa sổ ngữ cảnh là tổng lượng nội dung mô hình có thể tham chiếu khi tạo câu trả lời. Tài liệu chính thức của Anthropic về context window gọi đây là “working memory”, tức bộ nhớ làm việc. Nó khác dữ liệu mà mô hình đã dùng để huấn luyện.
Sự khác biệt này khá quan trọng. Dữ liệu huấn luyện giúp mô hình hình thành khả năng ngôn ngữ và kiến thức nền. Context window là phần thông tin được đưa cho mô hình ở thời điểm bạn đặt câu hỏi. Một model có thể biết cách viết hợp đồng từ quá trình huấn luyện, nhưng muốn rà đúng hợp đồng của công ty bạn thì nội dung hợp đồng phải nằm trong ngữ cảnh hoặc được truy xuất từ nguồn mà nó có quyền đọc.
Với ứng dụng chat thông thường, người dùng chỉ thấy ô nhập và câu trả lời. Phía sau có thể còn nhiều thứ khác: lời nhắc hệ thống, tin nhắn cũ, mô tả công cụ, kết quả tìm kiếm, ảnh, PDF và dữ liệu do phần mềm chèn vào. Những phần ấy không hiện đầy đủ trên màn hình nhưng vẫn có thể chiếm dung lượng.
Token là gì và có phải một token bằng một từ?
Token là đơn vị nhỏ mà mô hình dùng để xử lý văn bản. Một token có thể là cả từ ngắn, một phần của từ, dấu câu hoặc vài ký tự. Quá trình chia nội dung thành các mảnh như vậy gọi là tokenization, tạm dịch là tách token.
Không nên đổi token sang số từ bằng một công thức cố định. Cách tách phụ thuộc model, bộ mã hóa và ngôn ngữ. Trang hướng dẫn đếm token của Google Gemini đưa ra ước lượng khoảng bốn ký tự cho một token và 100 token tương đương 60 đến 80 từ tiếng Anh. Đó là con số tham khảo cho tiếng Anh, không phải lời hứa cho văn bản tiếng Việt.
Tiếng Việt có dấu, nhiều từ ghép được viết bằng các tiếng cách nhau và có cách tách khác tiếng Anh. Mã nguồn, JSON, đường dẫn, bảng biểu hoặc chuỗi số cũng tiêu tốn token theo kiểu riêng. Muốn biết chính xác cho API đang dùng, hãy gọi công cụ đếm token của nhà cung cấp hoặc xem số liệu usage trong phản hồi. Đếm bằng mắt chỉ hợp để ước lượng sơ bộ.
Những gì được tính vào cửa sổ ngữ cảnh?
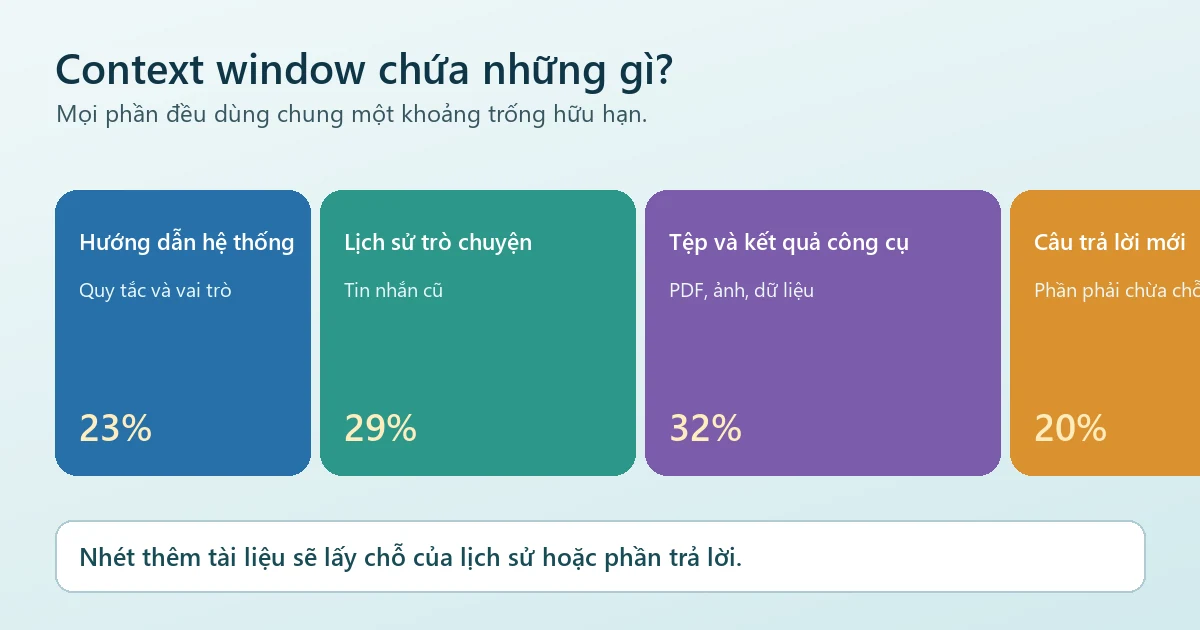
Nhiều người nghĩ chỉ câu hỏi mới chiếm context. Thực tế, một yêu cầu API có thể gồm nhiều lớp nội dung:
- hướng dẫn hệ thống quy định vai trò, cách trả lời và giới hạn an toàn;
- các lượt hỏi đáp trước đó mà ứng dụng gửi lại;
- câu hỏi mới của người dùng;
- tệp, hình ảnh hoặc đoạn văn được trích từ tài liệu;
- mô tả công cụ và kết quả công cụ;
- phần suy luận nội bộ nếu nền tảng tính nó vào giới hạn;
- câu trả lời mà mô hình chuẩn bị sinh ra.
Cách tính cụ thể không giống nhau giữa mọi dịch vụ. Anthropic nêu rõ system prompt, tin nhắn, kết quả công cụ, ảnh, tài liệu và đầu ra đều liên quan đến dung lượng cửa sổ trên API của họ. Google cũng cho biết context window quyết định lượng đầu vào có thể cung cấp và lượng đầu ra model có thể tạo. Vì vậy, khi chọn model, cần đọc đúng tài liệu của model và đúng nền tảng đang gọi, đừng lấy thông số của một nơi gắn sang nơi khác.
Một lỗi dễ gặp là dùng gần hết giới hạn cho tài liệu đầu vào rồi vẫn yêu cầu bản báo cáo dài. Phần trả lời cũng cần chỗ. Nếu ứng dụng không dành sẵn ngân sách đầu ra, API có thể báo yêu cầu quá dài hoặc câu trả lời bị dừng sớm.
Vì sao AI đang nói chuyện lại quên nội dung cũ?
Giao diện chat tạo cảm giác AI nhớ cả cuộc trò chuyện, nhưng ứng dụng thường phải gửi lại lịch sử cần thiết ở mỗi lượt. Khi chuỗi hội thoại dài dần, tổng token tăng lên. Đến gần giới hạn, hệ thống phải cắt bớt tin nhắn cũ, tóm tắt chúng hoặc mở một phiên ngữ cảnh mới.
Đó là lý do bạn có thể đã đưa một yêu cầu ở đầu cuộc trò chuyện, vài chục lượt sau AI lại làm khác. Phần yêu cầu cũ có thể không còn được gửi nguyên văn. Cũng có trường hợp nó vẫn nằm trong cửa sổ nhưng bị chìm giữa quá nhiều nội dung. “Có trong ngữ cảnh” và “được model chú ý đúng lúc” là hai chuyện khác nhau.
Nếu một quy tắc thật sự quan trọng, hãy nhắc lại ngắn gọn trước bước cần áp dụng. Với công việc dài, nên lưu quyết định, trạng thái và việc còn lại vào một tệp riêng. Cách này bền hơn việc hy vọng model tự nhớ một câu nằm đâu đó trong cuộc chat từ sáng đến chiều.
Context window dài hơn có luôn tốt hơn không?
Không. Nó mở thêm khả năng, nhưng cũng kéo theo chi phí và nhiễu. Tài liệu của Anthropic cảnh báo rằng khi số token tăng, độ chính xác và khả năng nhớ lại chi tiết có thể giảm, hiện tượng họ gọi là context rot. Nói đơn giản, model được phát một xấp giấy rất dày và chi tiết quan trọng có thể nằm ở trang 317, giữa hai phụ lục chẳng liên quan.
Ngữ cảnh dài có ích khi nội dung thật sự liên quan: phân tích nhiều chương của hồ sơ, dò mối liên hệ trong mã nguồn, đối chiếu biên bản qua nhiều cuộc họp hoặc làm việc với một agent qua nhiều bước. Nó kém hiệu quả khi bạn đổ cả thư mục vào chỉ để hỏi một câu có thể trả lời từ hai trang hướng dẫn.
Đầu vào dài cũng có thể làm tăng thời gian phản hồi và chi phí theo token. Prompt caching có thể giảm chi phí cho phần nội dung lặp lại trên một số nền tảng, nhưng phần đã cache vẫn chiếm cửa sổ ngữ cảnh. Cache giúp hóa đơn nhẹ hơn, không làm chiếc vali rộng thêm.
Ví dụ dễ hiểu: hỏi AI về quy trình nội bộ
Giả sử phòng IT có 200 tài liệu: quy trình cấp tài khoản, hướng dẫn VPN, biểu mẫu mua sắm, biên bản họp và tài liệu thiết bị. Một nhân viên hỏi: “Tôi đổi điện thoại thì đăng ký lại xác thực hai lớp thế nào?”
Cách thô là đưa cả 200 tài liệu vào context window. Model có thể đọc được nếu giới hạn đủ lớn, nhưng yêu cầu sẽ nặng, chậm và có nhiều nội dung thừa. Cách hợp lý hơn là tìm đúng các đoạn về đổi thiết bị và xác thực hai lớp, rồi chỉ gửi những đoạn ấy kèm câu hỏi. Đây là ý tưởng của RAG, kỹ thuật cho AI tìm tài liệu trước khi trả lời.
Nếu câu hỏi yêu cầu so sánh chính sách qua nhiều năm, cửa sổ ngữ cảnh dài lại có lợi vì ứng dụng có thể cung cấp nhiều phiên bản để model đối chiếu. Vẫn cần ghi rõ ngày hiệu lực và nguồn. Model không tự biết bản PDF tên “quytrinh_final_moi2.pdf” mới hơn bản “quytrinh_chot_that.pdf”. Chuyện đặt tên file như vậy thì máy cũng có quyền bối rối.
Context window khác RAG và bộ nhớ dài hạn ra sao?
Ba khái niệm này thường bị trộn với nhau.
Context window là vùng thông tin model đang thấy trong lần xử lý hiện tại. RAG là quy trình tìm các đoạn liên quan từ kho dữ liệu rồi đưa chúng vào vùng đó. Bộ nhớ dài hạn là dữ liệu được lưu bên ngoài để dùng lại ở phiên sau, chẳng hạn hồ sơ người dùng, cơ sở dữ liệu hoặc tệp trạng thái.
Một ứng dụng có thể dùng cả ba. Bộ nhớ lưu rằng người dùng thích báo cáo ngắn. RAG tìm quy định mới nhất. Context window chứa câu hỏi, sở thích, đoạn quy định vừa lấy và hướng dẫn trả lời. Model xử lý những phần đó để tạo kết quả.
Cửa sổ một triệu token không tự biến thành trí nhớ vô hạn. Nếu đóng phiên mà ứng dụng không lưu dữ liệu cần thiết, model không có chỗ để lấy lại ở lần sau. Ngược lại, có kho nhớ lớn mà truy xuất sai thì model vẫn nhận nhầm ngữ cảnh. Khâu tìm và chọn dữ liệu thường quyết định chất lượng nhiều hơn con số quảng cáo.
Cách quản lý context window khi dùng chatbot
Người dùng phổ thông không cần tự xây hệ thống token. Vài thói quen sau đã giúp cuộc trò chuyện rõ hơn:
Tách chủ đề khi cuộc chat đã đi quá xa
Nếu cuộc trò chuyện bắt đầu bằng sửa Excel, rẽ sang mua laptop rồi quay lại viết quy trình, hãy mở chat mới cho công việc mới. Bạn giảm nội dung thừa và tránh để yêu cầu cũ ảnh hưởng câu trả lời hiện tại.
Gửi phần tài liệu có liên quan
Với tệp dài, nói rõ chương, trang hoặc mục cần xem. Nếu mục tiêu là rà điều khoản thanh toán, không nhất thiết yêu cầu model phân tích cả phụ lục kỹ thuật. Khi cần đánh giá toàn bộ tài liệu, hãy chia việc thành các bước và có bản tổng hợp cuối.
Chốt lại yêu cầu trước bước quan trọng
Sau nhiều lượt trao đổi, viết một đoạn ngắn gồm mục tiêu, dữ kiện đã thống nhất, điều cấm và định dạng đầu ra. Đừng bảo AI “làm như đã nói ở trên” rồi bắt nó đào khảo cổ cả cuộc chat.
Kiểm tra nguồn thay vì tin vào vẻ trôi chảy
Ngữ cảnh dài không loại bỏ ảo giác, tức nội dung nghe hợp lý nhưng không có căn cứ. Yêu cầu trích nguồn, mở lại đúng đoạn tài liệu và so sánh số liệu quan trọng. Bài cách kiểm chứng câu trả lời AI có một quy trình cụ thể cho việc này.
Cách quản lý ngữ cảnh khi xây ứng dụng AI
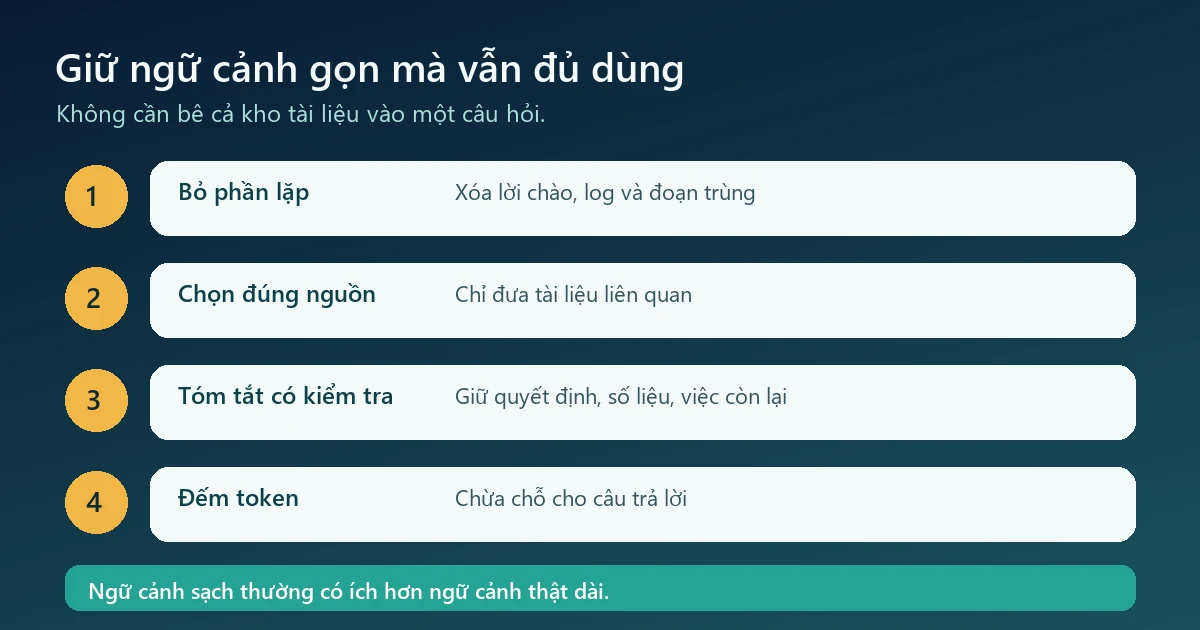
Với lập trình viên, bước đầu tiên là đo. Dùng API đếm token trước khi gửi nếu nhà cung cấp có hỗ trợ, đồng thời lưu số token đầu vào và đầu ra sau mỗi yêu cầu. Đặt ngân sách riêng cho system prompt, lịch sử, tài liệu truy xuất, kết quả công cụ và câu trả lời.
Đừng cắt lịch sử chỉ theo số ký tự. Hãy giữ hướng dẫn đang có hiệu lực, các quyết định chưa hoàn thành và dữ kiện cần cho bước tiếp theo. Kết quả công cụ cũ, log dài hoặc nội dung đã được tổng hợp có thể bỏ. Nếu tóm tắt lịch sử, cần bảo toàn con số, tên tệp, ràng buộc và việc còn dang dở; bản tóm tắt kiểu “đã thảo luận nhiều vấn đề” gần như vô dụng.
Với tài liệu, nên chia thành đoạn có ranh giới hợp lý, lưu metadata như tên tài liệu, phiên bản, ngày hiệu lực và quyền truy cập. Tìm kiếm kết hợp từ khóa với ngữ nghĩa thường an toàn hơn chỉ dựa vào độ giống vector. Sau truy xuất, xếp hạng lại và bỏ đoạn không liên quan trước khi đưa vào prompt.
Ứng dụng dài phiên có thể dùng compaction, tức nén lịch sử bằng bản tóm tắt. Tài liệu compaction của Anthropic mô tả cách thay các lượt cũ bằng một khối tóm tắt để giữ cuộc trò chuyện trong giới hạn. Dù dùng tính năng của nền tảng hay tự viết, cần kiểm thử xem bản tóm tắt có làm mất quyết định quan trọng hay không.
Chọn model theo context window thế nào cho đỡ phí?
Bắt đầu từ loại dữ liệu và câu hỏi, không bắt đầu từ model có số token lớn nhất. Nếu ứng dụng chỉ trả lời câu hỏi ngắn từ vài trang hướng dẫn, một cửa sổ vừa phải cùng bộ truy xuất tốt có thể đủ. Nếu cần phân tích kho mã, nhiều hồ sơ dài hoặc agent chạy hàng trăm bước, dung lượng lớn và công cụ quản lý ngữ cảnh đáng cân nhắc hơn.
Khi so sánh, hãy kiểm tra bốn thông tin trong tài liệu chính thức: giới hạn đầu vào, giới hạn đầu ra, cách tính token cho ảnh hoặc tệp, và giá khi dùng ngữ cảnh dài. Thông số thay đổi theo model, phiên bản API và nền tảng triển khai. Một model được quảng cáo hỗ trợ ngữ cảnh lớn chưa chắc mọi giao diện người dùng đều cho tải lượng nội dung tương đương.
Thử bằng dữ liệu thật nhưng đã loại thông tin nhạy cảm. Tạo bộ câu hỏi gồm chi tiết ở đầu, giữa và cuối tài liệu; câu hỏi cần kết hợp nhiều đoạn; câu không có đáp án; và câu có nội dung gây nhiễu. Đo xem model tìm đúng nguồn, từ chối khi thiếu bằng chứng và giữ đúng yêu cầu qua nhiều lượt hay không. Chỉ kiểm tra một câu dễ ở trang đầu thì model nào cũng có thể trông rất ngoan.
Hiểu đúng context window để dùng AI tỉnh táo hơn
Context window là lượng thông tin mô hình có thể dùng trong một lần xử lý, gồm nhiều thứ hơn câu hỏi bạn vừa gõ. Token là đơn vị đo dung lượng đó, nhưng không quy đổi cố định thành số từ. Cửa sổ lớn giúp xử lý nhiều nội dung hơn, không bảo đảm model sẽ chú ý đúng mọi chi tiết.
Khi dùng chatbot, hãy tách chủ đề, đưa đúng tài liệu, nhắc lại yêu cầu quan trọng và kiểm tra nguồn. Khi xây ứng dụng, hãy đo token, dành chỗ cho đầu ra, truy xuất có chọn lọc và tóm tắt lịch sử bằng tiêu chí rõ ràng. Làm được vậy, bạn không cần biến mỗi prompt thành một xe tải chở giấy chỉ để hỏi một câu.
Nguồn tham khảo: Anthropic: Context windows; Anthropic: Compaction; Google AI for Developers: Understand and count tokens; Google AI for Developers: Long context.