LFM2.5-24B-A2B là gì? AI mã nguồn mở của Liquid AI chạy ngay trên thiết bị
LFM2.5-24B-A2B là model AI mã nguồn mở của Liquid AI, ra mắt 13/10/2026, 24 tỷ tham số nhưng chỉ kích hoạt 2,45 tỷ mỗi lượt, tối ưu cho agent on-device.
Bởi Danh Võ — 26 Tháng 10, 2026 trong Công cụ AI
LFM2.5-24B-A2B là model AI mã nguồn mở mới nhất của Liquid AI, ra mắt ngày 13/10/2026, được thiết kế riêng cho các agent chạy ngay trên thiết bị (on-device agent) — từ laptop, điện thoại đến máy chủ nhỏ — mà không cần gửi dữ liệu lên cloud. Điểm đặc biệt: model có 24 tỷ tham số nhưng chỉ kích hoạt khoảng 2,45 tỷ tham số mỗi lượt suy luận, nhờ vậy chạy nhanh hơn hẳn các model cùng cỡ mà vẫn giữ được chất lượng cạnh tranh. Bài viết này tổng hợp thông số kỹ thuật, tốc độ thực tế, so sánh benchmark với Qwen3.6-35B-A3B, và cách bạn có thể tự chạy LFM2.5-24B-A2B dựa trên các nguồn tin đã xác minh.
LFM2.5-24B-A2B là gì?
LFM2.5-24B-A2B là model lớn nhất trong dòng LFM2.5 của Liquid AI, kế thừa kiến trúc từ phiên bản tiền nhiệm LFM2-24B-A2B. Đây là model mixture-of-experts (MoE) dạng reasoning, gồm 40 lớp kết hợp 30 block tích chập cổng kép (double-gated short convolution) và 10 block grouped-query attention, với 64 expert mỗi block MoE và cơ chế định tuyến top-4. Theo bài blog chính thức trên Hugging Face, Liquid AI định vị model này cho các agent cần phản hồi nhanh, chạy riêng tư ngay trên thiết bị, không phụ thuộc kết nối cloud liên tục.
So với bản LFM2-24B-A2B cũ, LFM2.5-24B-A2B mở rộng context window từ 32.000 lên 131.072 token, đồng thời tăng gấp đôi vocabulary từ 65.000 lên 128.000 token — giúp model xử lý tốt hơn các ngôn ngữ ngoài tiếng Anh và văn bản dài.
Thông số kỹ thuật đáng chú ý
| Thông số | Giá trị |
|---|---|
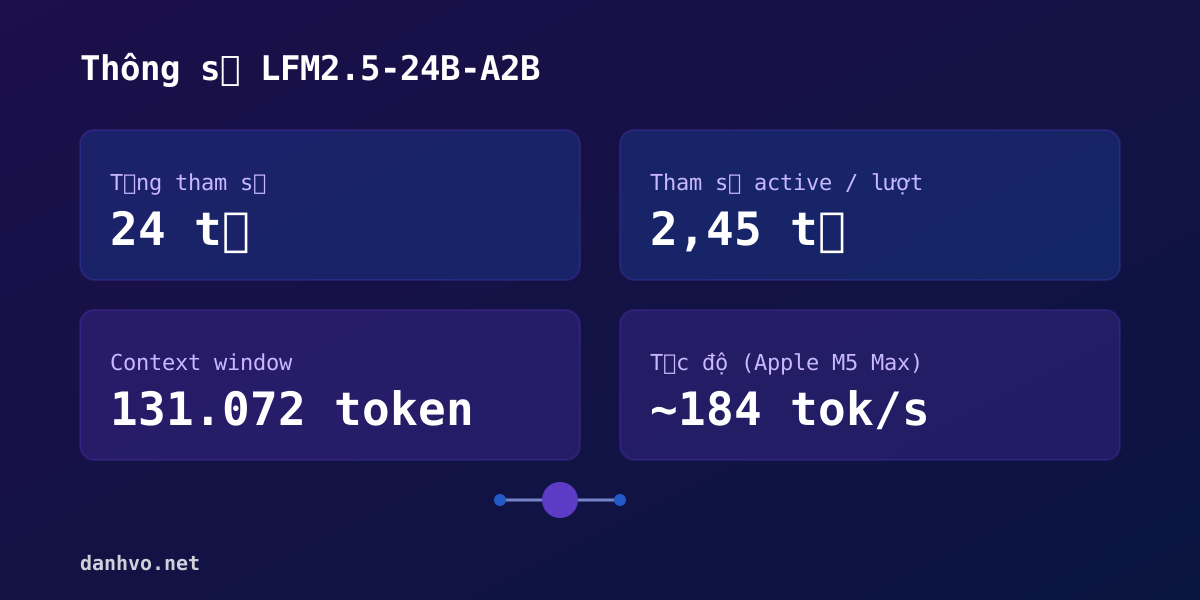
| Tổng số tham số | 24 tỷ |
| Tham số kích hoạt mỗi lượt (active) | ~2,45 tỷ |
| Kiến trúc | Mixture-of-experts, 40 lớp, 64 expert/block, định tuyến top-4 |
| Context window | 131.072 token |
| Vocabulary | 128.000 token |
| Ngày ra mắt | 13/10/2026 |
| Giấy phép | LFM Open License v1.0 — miễn phí cho doanh nghiệp doanh thu dưới 10 triệu USD/năm |
| Nơi phát hành | Hugging Face (base + post-trained checkpoint) |
Vì chỉ kích hoạt một phần nhỏ tham số mỗi lượt, LFM2.5-24B-A2B tiêu tốn ít tài nguyên hơn nhiều so với model dense cùng kích thước — đây cũng là lý do Liquid AI gọi nó là model “fast” ngay trong tên bài giới thiệu. Nếu bạn muốn hiểu sâu hơn vì sao các model MoE như thế này tiết kiệm tài nguyên khi chạy cục bộ, có thể xem thêm bài quantization là gì và cách chọn Q4, Q5, Q8 khi chạy AI cục bộ.
Tốc độ thực tế: bao nhiêu token/giây?
Liquid AI công bố LFM2.5-24B-A2B đạt khoảng 184 token/giây khi chạy trên Apple M5 Max (bản lượng tử hóa chạy on-device), và lên tới 21.000 token/giây tổng hợp trên một GPU NVIDIA B300 khi phục vụ nhiều request đồng thời ở trung tâm dữ liệu. Cần lưu ý hai con số này đo trong hai điều kiện rất khác nhau — một là single-stream trên thiết bị cá nhân, một là throughput gộp nhiều request trên GPU datacenter — nên không thể so sánh trực tiếp với nhau. Claim “nhanh hơn 1,7 lần” mà một số nguồn nhắc tới cũng chưa có baseline so sánh cụ thể được công bố, nên nên xem đây là số liệu tham khảo từ hãng.
So benchmark với Qwen3.6-35B-A3B
Theo dữ liệu benchmark do Liquid AI công bố, LFM2.5-24B-A2B vượt hoặc ngang dòng Qwen của Alibaba, cụ thể là Qwen3.6-35B-A3B, trên 5/8 benchmark agentic — dù model của Liquid AI nhỏ hơn và ít tham số active hơn:
- LiveClaw: LFM2.5-24B-A2B đạt 48,09 điểm, Qwen3.6-35B-A3B đạt 38,19 điểm.
- AutomationBench: LFM2.5-24B-A2B đạt 27,69 điểm, Qwen3.6-35B-A3B đạt 8,72 điểm.
- ToolSandbox: LFM2.5-24B-A2B đạt 80,71 điểm, Qwen3.6-35B-A3B đạt 75,02 điểm.
- GPQA Diamond (kiến thức tổng hợp): Qwen3.6-35B-A3B vượt lên với 83,69 điểm so với 74,42 điểm của LFM2.5-24B-A2B.
- WebArena Verified (duyệt web agent): Qwen3.6-35B-A3B dẫn trước với 37,62 điểm so với 26,75 điểm.
Nhìn chung, LFM2.5-24B-A2B mạnh hơn ở các tác vụ agent/tool-calling thực chiến, còn Qwen3.6-35B-A3B vẫn nhượng bộ ở các bài kiểm tra kiến thức tổng hợp và duyệt web phức tạp. Đây là số liệu do chính Liquid AI công bố khi ra mắt, chưa có bên thứ ba độc lập kiểm chứng lại toàn bộ, nên nên xem là tham khảo ban đầu.
LFM2.5-24B-A2B dùng để làm gì?
Với kiến trúc nhẹ và context window dài, LFM2.5-24B-A2B phù hợp cho các tình huống thực tế sau:
- Trợ lý AI chạy offline trên laptop hoặc máy trạm cá nhân, không cần gửi dữ liệu nhạy cảm lên cloud.
- Agent gọi tool (tool-calling) trong ứng dụng doanh nghiệp, như tự động điền form, truy vấn API nội bộ.
- Ứng dụng cần phản hồi nhanh, độ trễ thấp hơn so với gọi API qua internet.
- Triển khai cho doanh nghiệp nhỏ muốn dùng miễn phí theo điều khoản LFM Open License (dưới 10 triệu USD doanh thu/năm).
Tải và chạy LFM2.5-24B-A2B ở đâu?
Liquid AI đã công bố cả bản base và bản post-trained của LFM2.5-24B-A2B trên Hugging Face ngay từ ngày ra mắt, kèm theo tài liệu kỹ thuật chi tiết trên Liquid Docs. Vì là model mở, bạn có thể tự tải trọng số về và chạy bằng các công cụ inference phổ biến hỗ trợ kiến trúc MoE, hoặc dùng API của Liquid AI nếu không muốn tự host hạ tầng.
Giấy phép LFM Open License v1.0 cho phép dùng thương mại miễn phí, nhưng chỉ áp dụng với doanh nghiệp có doanh thu hàng năm dưới 10 triệu USD — doanh nghiệp lớn hơn cần liên hệ Liquid AI để mua license riêng. Đây là điểm khác với các model mở hoàn toàn permissive như một số bản Nemotron của NVIDIA, nên bạn cần đọc kỹ điều khoản trước khi đưa vào sản phẩm thương mại.
Câu hỏi thường gặp
LFM2.5-24B-A2B có miễn phí không?
Có, với điều kiện doanh nghiệp của bạn có doanh thu hàng năm dưới 10 triệu USD theo LFM Open License v1.0. Doanh nghiệp lớn hơn cần mua license thương mại riêng từ Liquid AI.
LFM2.5-24B-A2B cần cấu hình phần cứng thế nào để chạy cục bộ?
Nhờ chỉ kích hoạt khoảng 2,45 tỷ tham số mỗi lượt, model chạy được trên phần cứng cá nhân như MacBook dùng chip Apple Silicon đời mới, đạt khoảng 184 token/giây ở bản lượng tử hóa. Nếu cần tốc độ phục vụ nhiều người dùng, nên host trên GPU trung tâm dữ liệu.
LFM2.5-24B-A2B có tốt hơn Qwen hoàn toàn không?
Không hoàn toàn. Model này vượt Qwen3.6-35B-A3B ở các benchmark agentic và tool-calling, nhưng thua ở bài kiểm tra kiến thức tổng hợp (GPQA Diamond) và duyệt web phức tạp (WebArena Verified). Nên chọn model phù hợp theo tác vụ cụ thể thay vì dựa vào một con số tổng quát.
Kết luận
LFM2.5-24B-A2B cho thấy hướng đi rõ ràng của Liquid AI: xây model mở, nhẹ nhưng vẫn đủ mạnh cho agent thực chiến chạy ngay trên thiết bị, thay vì chạy đua tham số với các hãng lớn. Với 24 tỷ tham số nhưng chỉ kích hoạt 2,45 tỷ mỗi lượt, context window 131.072 token và kết quả vượt trội ở nhiều benchmark agentic so với Qwen3.6-35B-A3B, đây là lựa chọn đáng cân nhắc nếu bạn cần một trợ lý AI chạy offline, phản hồi nhanh và không phải trả phí nếu doanh nghiệp còn nhỏ. Tuy nhiên, các số liệu benchmark hiện tại chủ yếu do Liquid AI tự công bố, nên tốt nhất bạn nên tự test trên tác vụ thực tế của mình trước khi quyết định đưa vào sản phẩm.