Nemotron 3.5 Super VL là gì? NVIDIA tung AI mã nguồn mở 120 tỷ tham số, nhanh gấp 5 lần
Nemotron 3.5 Super VL là model vision-language mã nguồn mở 120 tỷ tham số của NVIDIA, ra mắt 15/10/2026, tốc độ nhanh gấp 5 lần model cùng hạng.
Bởi Danh Võ — 23 Tháng 10, 2026 trong AI
Nemotron 3.5 Super VL là model AI thị giác-ngôn ngữ (vision-language) mã nguồn mở mới của NVIDIA, ra mắt ngày 15/10/2026 với 120 tỷ tham số. Đây là bản mở rộng mới nhất của họ Nemotron, nhắm tới các tác vụ agent luôn hoạt động (always-on agent) cần đọc hiểu văn bản, hình ảnh, biểu đồ, trang web và tài liệu. Điểm đáng chú ý nhất: NVIDIA công bố toàn bộ trọng số, dữ liệu huấn luyện và quy trình training — khác hẳn cách OpenAI hay Google giữ kín các model flagship. Bài này tổng hợp thông số, hiệu năng và cách dùng Nemotron 3.5 Super VL dựa trên các nguồn tin đã xác minh.
Nemotron 3.5 Super VL là gì?
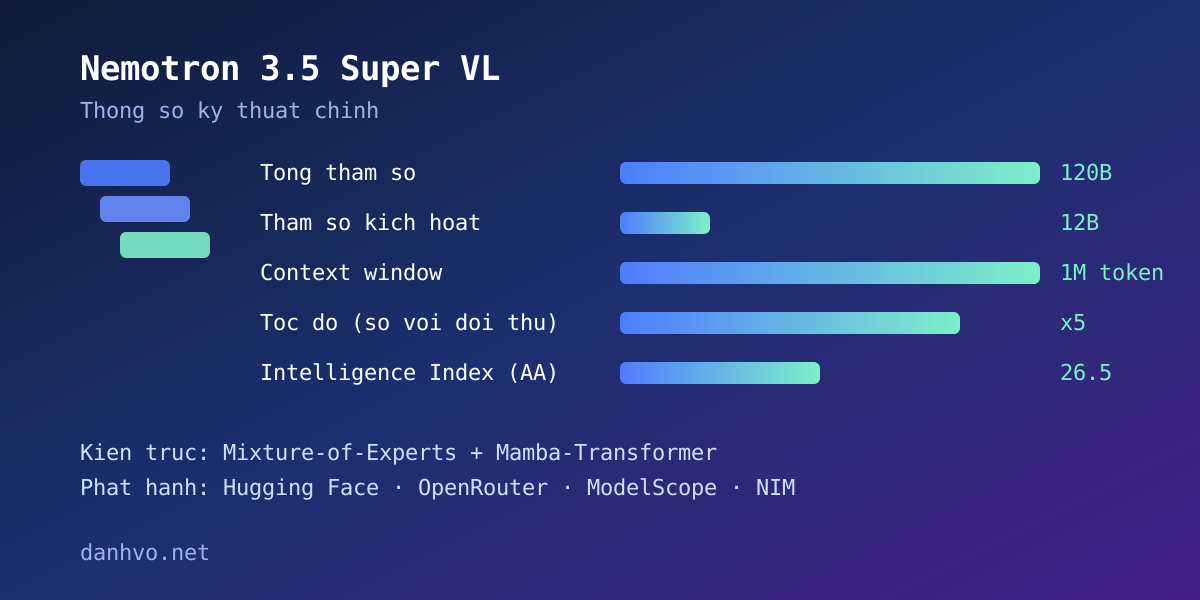
Nemotron 3.5 Super VL là model mixture-of-experts (MoE) dạng lai Mamba-Transformer, tổng cộng 120 tỷ tham số nhưng chỉ kích hoạt khoảng 12 tỷ tham số mỗi lượt suy luận. Nhờ kiến trúc này, Nemotron 3.5 Super VL vừa xử lý được ngữ cảnh dài (lên tới 1 triệu token) vừa tiết kiệm tài nguyên tính toán hơn nhiều so với model dense cùng cỡ.
NVIDIA định vị Nemotron 3.5 Super VL cho nhóm agent doanh nghiệp cần “nhìn” và “đọc” đồng thời: ảnh chụp màn hình, bảng biểu, trang web, file PDF nhiều cột. Theo HPCwire, NVIDIA mô tả đây là model mở lớn nhất trong họ Nemotron tính đến thời điểm ra mắt, và toàn bộ trọng số, dataset, recipe huấn luyện đều được công bố công khai trên Hugging Face.
Thông số kỹ thuật đáng chú ý
| Thông số | Giá trị |
|---|---|
| Tổng số tham số | 120 tỷ |
| Tham số kích hoạt mỗi lượt (active) | ~12 tỷ |
| Kiến trúc | Mixture-of-experts, lai Mamba-Transformer |
| Loại model | Vision-language (đọc text + ảnh + biểu đồ + trang web + tài liệu) |
| Context window | Tới 1 triệu token |
| Ngày ra mắt | 15/10/2026 |
| Giấy phép | Mã nguồn mở, công bố cả trọng số, dữ liệu và training recipe |
| Nơi phát hành | Hugging Face, OpenRouter, ModelScope, NVIDIA NIM |
Bolt 74B-A9B và Bolt E4B — các phiên bản nhỏ hơn
Cùng ngày, NVIDIA phát hành thêm hai model nhỏ hơn trong cùng đợt cập nhật:
- Bolt 74B-A9B: tối ưu để chạy cục bộ trên RTX và DGX Spark, dùng lượng tử hóa 2-bit gốc để vừa trong khoảng 24GB VRAM. Model này đã có sẵn ngay khi công bố.
- Bolt E4B: bản siêu nhẹ chỉ khoảng 4GB, nhắm tới agent hội thoại nhanh và thiết bị edge, dự kiến phát hành ngày 23/10/2026.
Việc tung cùng lúc một model lớn (Super VL) và hai model gọn nhẹ (Bolt) cho thấy NVIDIA muốn phủ cả hai đầu: trung tâm dữ liệu và máy tính cá nhân.
Hiệu năng: nhanh gấp 5 lần, điểm số ra sao?
NVIDIA tuyên bố Nemotron 3.5 Super VL chạy nhanh hơn tới 5 lần so với các model cùng hạng, đồng thời đạt hiệu năng tương đương model reasoning lớn nhất của chính NVIDIA nhưng chỉ bằng khoảng 1/5 số tham số. Theo bài kiểm định độc lập của Artificial Analysis, tốc độ sinh token của Nemotron 3.5 Super VL đạt khoảng 630 token/giây ở prompt 100.000 token (đo trên endpoint pre-release), với điểm Intelligence Index là 26,5.
Đây là những số liệu từ bên thứ ba, nên đáng tin hơn các benchmark do hãng tự công bố — nhưng vẫn cần lưu ý đây là kết quả trên bản pre-release, con số chính thức có thể thay đổi đôi chút khi model ổn định hơn.
Nemotron 3.5 Super VL dùng để làm gì?
Với khả năng đọc hiểu đa phương thức và context window dài, Nemotron 3.5 Super VL phù hợp cho các tác vụ như:
- Agent tự động đọc và tổng hợp báo cáo PDF, bảng biểu phức tạp.
- Tác vụ duyệt web tự động (web agent) cần “nhìn” giao diện trang web để thao tác.
- Phân loại và trích xuất dữ liệu từ ảnh chụp màn hình, hóa đơn, biểu đồ.
- Ứng dụng always-on agent chạy liên tục trong quy trình doanh nghiệp, nhờ chi phí tính toán thấp hơn nhờ kiến trúc MoE.
Nếu bạn đang tìm hiểu vì sao context window 1 triệu token không đồng nghĩa với model “nhớ” tốt hơn, có thể xem thêm bài context window là gì, vì sao AI quên để hiểu rõ giới hạn thực tế của thông số này.
Tải và dùng Nemotron 3.5 Super VL ở đâu?
Nemotron 3.5 Super VL và Bolt 74B-A9B đã có sẵn ngay từ ngày ra mắt, phân phối qua ba kênh chính: Hugging Face (tải trọng số), OpenRouter (dùng qua API trả theo token), và ModelScope. Ngoài ra NVIDIA cũng đưa model lên NIM — nền tảng triển khai AI cho môi trường production của chính hãng, phù hợp cho doanh nghiệp muốn tự host trên hạ tầng GPU riêng.
Vì là model mở, bạn có thể tự chạy Nemotron 3.5 Super VL trên server riêng mà không phụ thuộc API của NVIDIA — khác với cách tiếp cận đóng của nhiều model flagship khác.
So với các model mở khác thì sao?
NVIDIA không phải hãng duy nhất chạy theo hướng mã nguồn mở. Trước đó, Mistral AI cũng công bố Mistral Large 4 (Le Chonk) với lời hứa mở trọng số, còn phía Trung Quốc có Kimi K3 — model mã nguồn mở 2,8 nghìn tỷ tham số từng vượt Claude khi code frontend. Điểm khác biệt của Nemotron 3.5 Super VL là nó tập trung vào vision-language và agent đa phương thức, thay vì chỉ thuần văn bản hoặc code như hai model kể trên.
So với Qwen 4 của Alibaba — vốn cũng nhắm tới thị trường model mở — Nemotron 3.5 Super VL có lợi thế là đã công bố đầy đủ benchmark độc lập từ Artificial Analysis ngay khi ra mắt, trong khi nhiều model mở khác thường chỉ có số liệu tự công bố ở giai đoạn đầu.
Câu hỏi thường gặp
Nemotron 3.5 Super VL có miễn phí không?
Có, đây là model mã nguồn mở, bạn có thể tải trọng số từ Hugging Face và tự chạy miễn phí trên hạ tầng riêng. Nếu dùng qua OpenRouter hoặc NIM dưới dạng API, bạn vẫn trả phí theo token như bình thường.
Nemotron 3.5 Super VL cần cấu hình phần cứng thế nào?
Bản Super VL 120 tỷ tham số cần GPU trung tâm dữ liệu để chạy hiệu quả. Nếu muốn chạy trên máy cá nhân, nên chọn bản Bolt 74B-A9B (vừa trong 24GB VRAM nhờ lượng tử hóa 2-bit) hoặc Bolt E4B (chỉ khoảng 4GB) khi phát hành.
Nemotron 3.5 Super VL có mạnh hơn các model đóng như GPT hay Gemini không?
Chưa có benchmark độc lập so sánh trực tiếp với các model đóng lớn nhất. NVIDIA chỉ công bố Nemotron 3.5 Super VL tương đương model reasoning lớn nhất của chính họ với ít tham số hơn, nên nên xem đây là bước tiến về hiệu quả hơn là tuyên bố vượt mặt toàn bộ thị trường.
Kết luận
Nemotron 3.5 Super VL đánh dấu bước đi tiếp theo của NVIDIA trong chiến lược phổ cập AI mã nguồn mở, với model vision-language 120 tỷ tham số nhưng chỉ kích hoạt 12 tỷ mỗi lượt, context window tới 1 triệu token và tốc độ được công bố nhanh gấp 5 lần model cùng hạng. Đi kèm hai phiên bản Bolt gọn nhẹ hơn, NVIDIA cho thấy rõ ý định phủ từ trung tâm dữ liệu tới máy tính cá nhân. Nếu bạn đang cần một model mở có khả năng đọc hiểu đa phương thức, Nemotron 3.5 Super VL là lựa chọn đáng theo dõi — nhưng như mọi model mới ra mắt, nên chờ thêm đánh giá độc lập trước khi đưa vào hệ thống production quan trọng.